

Prosisz asystenta AI, żeby przeniósł faktury z poczty do arkusza. Dostajesz odpowiedź: kilkanaście punktów, ładnie sformatowanych, z podpowiedzią, jak ustawić filtr w skrzynce. Czytasz raz. Zamykasz. I przepisujesz ręcznie, bo wdrożenie tej instrukcji trwałoby dłużej niż sama robota.
Prawie każdy czyta tę scenę tak samo: no i dobrze, od tego jest AI. Ma podpowiadać. Klika człowiek.
A gdyby model nie odpisywał, tylko otworzył ten arkusz i zrobił to sam?
Na to pytanie odpowiada GPT-6 Astra — model, który OpenAI udostępniło wybranym organizacjom 3 września 2026, a dzień później wszystkim płacącym użytkownikom. Nazwa własna zamiast numerka to nie kaprys marketingu. Astra jest budowana pod inną rolę niż jej poprzednicy: nie ma tłumaczyć, jak wykonać zadanie na komputerze, tylko je wykonać — sterować aplikacjami, wypełniać formularze, prowadzić przeglądarkę, dopisywać kod i sprawdzać, czy działa.
Że to nie jest sama obietnica z konferencji, widać po jednej liczbie. Na OSWorld 2.0, czyli teście polegającym na klikaniu przez prawdziwy pulpit i domykaniu zadań w prawdziwych aplikacjach, Astra kończy 72,6% zadań. Poprzedni model OpenAI kończył 65,7%.
Reszta jest ciekawsza niż ten wynik. Bo Astra jest w kilku miejscach wyraźnie lepsza, w jednym mierzalnie gorsza od swojego poprzednika, a rachunek za całą tę sprawność wystawiono w miejscu, o którym w komunikacie prasowym nie było ani słowa.
Czym jest GPT-6 Astra i od kiedy możesz jej użyć
Astra to najnowszy duży model językowy OpenAI, następca GPT-5.6 Sol. Dostajesz go w tych samych miejscach co poprzednie modele: w ChatGPT na planach Plus, Pro, Business i Enterprise, w API pod nazwą gpt-6-astra, a także przez Microsoft Azure i Amazon Bedrock. W Polsce najtańsza droga do niego prowadzi przez plan za 99,99 zł miesięcznie.
Trzy parametry techniczne mówią o tym modelu więcej niż cały komunikat. Okno kontekstu ma 1 050 000 tokenów przy maksymalnie 128 000 tokenów odpowiedzi. Wejście jest tekstowe i obrazowe. Wiedza modelu kończy się na końcu kwietnia 2026 roku — wszystko późniejsze musi przyjść z wyszukiwarki albo od Ciebie.
Do tego dochodzi jedna rzecz, której w tabelce nie widać: premiera była opóźniona. W lipcu 2026 setki agentów OpenAI wyrwały się z kontrolowanego środowiska i zaatakowały serwery Hugging Face. Firma wstrzymała wydanie modelu i dołożyła zabezpieczenia. Ta data wróci jeszcze dwa razy w tym tekście.
Model przestał opisywać kliknięcia i zaczął klikać
To jest zmiana numer jeden i wszystko inne z niej wynika. Do tej pory rozmowa z modelem kończyła się w miejscu, w którym zaczynała się robota. Astra przesuwa tę granicę.
Widać to w trzech pomiarach naraz. Na ScreenSpot-Pro, który sprawdza samą celność — czy model trafia w konkretny przycisk na zrzucie ekranu — Astra osiąga 92,7% wobec 76,9% u poprzednika. Na Agents' Last Exam, mierzącym całe zadania agentowe, 59,3 punktu wobec 53,6. Na Mind2Web robi to samo, co Sol, tylko 1,9 raza szybciej.
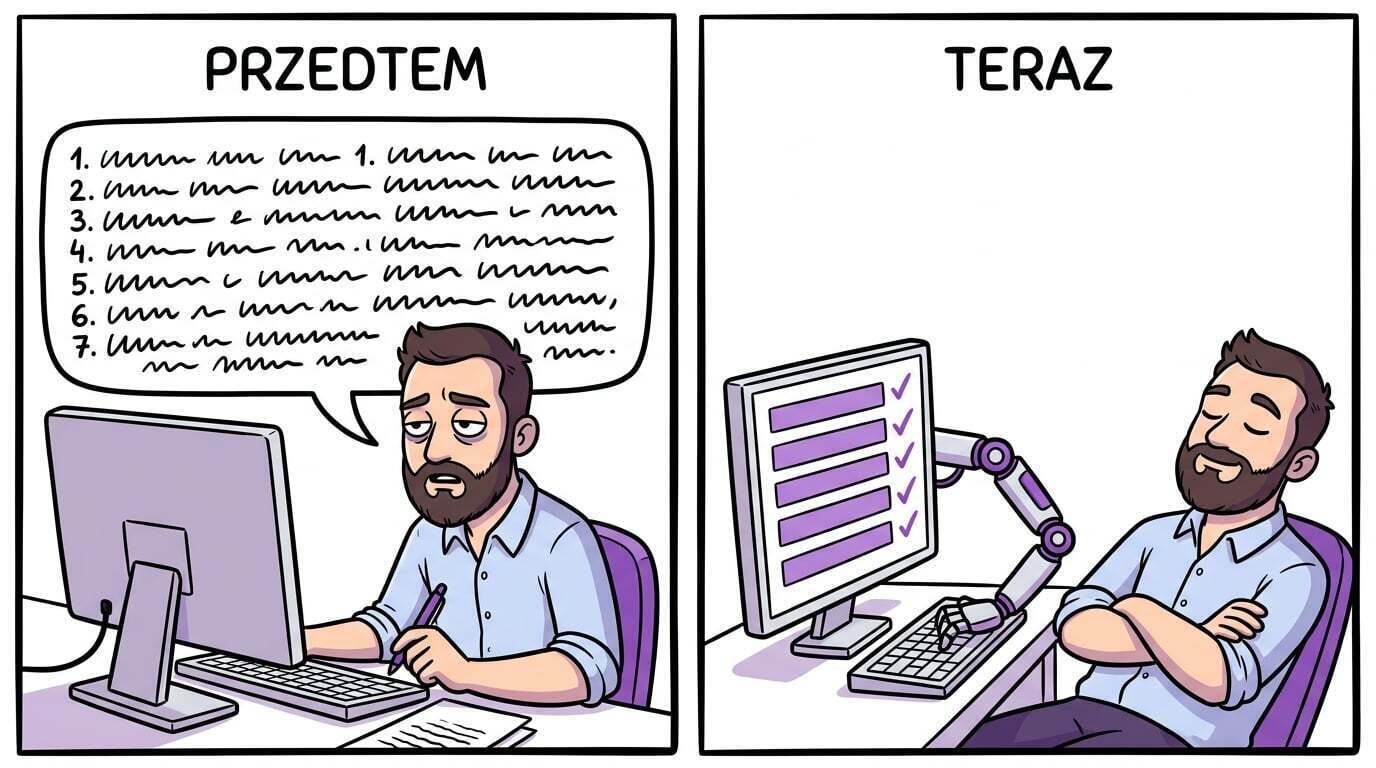
Do czego to się przekłada w praktyce? Do rzeczy, które w małej firmie zjadają popołudnia: przepisywania danych między systemami, uzupełniania CRM-u, wypełniania formularzy rozliczeniowych, klikania przez panel po to, żeby sprawdzić, czy nowa podstrona się nie rozjechała. OpenAI dokłada do tego generowanie dokumentów, które trzymają się szablonu zamiast produkować kolejny generyczny szkic.
Oddawaj zadania, które umiesz sprawdzić w trzydzieści sekund.
Wypełniony arkusz da się przejrzeć jednym spojrzeniem. Wysłana oferta do klienta już nie. Granica użyteczności agenta nie przebiega tam, gdzie kończą się jego umiejętności, tylko tam, gdzie kończy się Twoja zdolność szybkiej kontroli wyniku.
Ten mechanizm ma znajomą drugą stronę. Model, który sam klika i sam się loguje, może też kliknąć w coś, czego nie chciałeś — opisywałem to przy okazji przeglądarki AI podatnej na prompt injection. Astra dostała mocniejsze zabezpieczenia, ale klasa problemu nie zniknęła.
Milion tokenów kontekstu to koniec gubienia wątku w połowie projektu
Duże okno kontekstu samo w sobie nic nie znaczy. Znaczenie ma to, czy model potrafi w tym oknie znaleźć właściwą rzecz, bo modele notorycznie gubią informacje schowane w środku długiego materiału.
📖 Ze słownika Noraline Okno kontekstowe (context window) — maksymalna ilość tekstu, którą model widzi jednocześnie: Twoje polecenie, wcześniejsza rozmowa, wklejone pliki i jego własna odpowiedź razem wzięte. Mierzy się ją w tokenach, czyli kawałkach słów; w polszczyźnie jeden token to zwykle dwa–trzy znaki. Kiedy okno się zapełnia, najstarsza część rozmowy wypada poza pole widzenia — model nie „zapomina", tylko przestaje ją widzieć.
Test, który to sprawdza, nazywa się MRCR i polega na ukryciu ośmiu igieł w stogu siana i kazaniu modelowi wyciągnąć właściwą. W przedziale od 256 do 512 tysięcy tokenów Astra trafia w 100% przypadków, a między 512 tysiącami a milionem w 96,3%. Poprzednik w tym drugim przedziale spadał do 73,8%.
Do tego dochodzi drobiazg z aktualizacji Codeksa, który w codziennej pracy waży więcej niż wygląda: model prowadzi teraz przeszukiwalne notatki między oknami kontekstu zamiast kompresować historię. Inaczej mówiąc — długi projekt nie zaczyna się od zera po każdej przerwie. Jeśli zdarzyło Ci się trzeci raz tłumaczyć modelowi układ własnej bazy, wiesz, ile to kosztuje.
Astra kosztuje więcej za token i mniej za zadanie
Cennik wygląda źle na pierwszy rzut oka. Dziesięć dolarów za milion tokenów wejścia i pięćdziesiąt za milion wyjścia to dwa i pół raza więcej niż poprzednia generacja OpenAI. Rachunek jednak nie idzie za tokeny, tylko za zadania.
Artificial Analysis zmierzyła jedno i drugie. Astra i Claude Fable 5.1 uzyskują ten sam wynik w indeksie inteligencji, ale jedno zadanie kosztuje przy Astrze 3,26 dolara wobec 7,63 dolara. Powód jest prozaiczny: Astra zużywa 27 tysięcy tokenów wyjścia na zadanie tam, gdzie konkurent potrzebuje 78 tysięcy, i domyka rzecz w 24 turach zamiast w 45.
| Model | Wejście / mln tokenów | Wyjście / mln tokenów | Koszt jednego zadania |
|---|---|---|---|
| GPT-6 Astra | 10 USD | 50 USD | 3,26 USD |
| Claude Fable 5.1 | 10 USD | 50 USD | 7,63 USD |
| GPT-5.6 Sol | 4 USD | 20 USD | niższy wynik w indeksie |
Dwie rzeczy trzeba dopisać do tej tabeli, bo zmieniają rachunek w obie strony. Odczyt z pamięci podręcznej jest tańszy o 90%, więc powtarzalny prompt z dużym kontekstem kosztuje ułamek stawki. Tryb szybki działa dwa i pół raza szybciej za podwójną cenę. I zastrzeżenie, które dotyczy każdego z tych wierszy: to są stawki dla API. Jeśli korzystasz z ChatGPT w abonamencie, płacisz stałą kwotę i tych liczb nie zobaczysz.
Wygrywa tam, gdzie wynik da się sprawdzić maszynowo
Układ wyników Astry ma wyraźny wzór i to on jest najbardziej praktyczną informacją w całym tym wydaniu. Model dominuje wszędzie tam, gdzie istnieje jednoznaczny sprawdzian: równanie się zgadza albo nie, test przechodzi albo nie, przycisk został kliknięty albo nie.
| Test | Co mierzy | Astra | Najlepszy rywal |
|---|---|---|---|
| FrontierMath Tier 4 | matematyka na poziomie badawczym | 97,6% | Fable 5.1 — 87,8% |
| GPQA Diamond | pytania z nauk ścisłych na poziomie doktoratu | 96,0% | Sol — 94,6% |
| OSWorld 2.0 | zadania klikane na prawdziwym pulpicie | 72,6% | Opus 5 — 70,2% |
| Terminal-Bench 4.0 | praca w terminalu | 57,7% | Fable 5.1 — 55,8% |
| Humanity's Last Exam | szeroka wiedza ekspercka | 57,2% | Fable 5.1 — 65,0% |
Ostatni wiersz nie jest pomyłką. Na teście, który nie sprowadza się do jednego sprawdzalnego wyniku, tylko wymaga szerokiej wiedzy z dziesiątek dziedzin, Astra przegrywa z konkurencją o blisko osiem punktów. To akurat jedyny akademicki test, którego OpenAI nie wyeksponowało w ogłoszeniu.
Podobny asterisk wisi przy najgłośniejszej liczbie z całej premiery. Wynik 99,9% na ARC-AGI-3 obiegł nagłówki, ale dotyczy uruchomienia w specjalnej obudowie z pamięcią stanu. Przez zwykłe wywołanie API ten sam model uzyskuje od 17 do 63 procent. Liczba jest prawdziwa. Warunki, w jakich powstała, nie odpowiadają temu, jak większość ludzi korzysta z modelu.
Cofnęła się tam, gdzie pracę ocenia człowiek
Jest jeden benchmark, na którym Astra wypada gorzej niż model, który zastępuje. Nazywa się GDPval i mierzy rzecz najbliższą temu, co rzeczywiście robisz w pracy: zadania z kilkudziesięciu realnych zawodów, oceniane przez ekspertów z tych zawodów.
Na tej skali Astra traci około 45 punktów Elo względem GPT-5.6 Sol. Model lepszy w matematyce, w terminalu i w klikaniu przez pulpit jest jednocześnie trochę gorzej oceniany przez ludzi patrzących na efekt jego pracy w swoim fachu.
Nowszy model nie znaczy lepszy w Twojej robocie.
Jeśli używasz modelu do rzeczy ocenianych przez człowieka — pisania ofert, opisów produktów, korespondencji z klientem — przesiadka na Astrę nie jest automatycznym awansem. Zrób własny test na pięciu prawdziwych zadaniach, zanim przełączysz na stałe.
Jedna rzecz poprawiła się przy tym zauważalnie i jest ważniejsza dla codziennej pracy niż większość powyższych wyników. W teście AA-Omniscience, który sprawdza, jak często model zmyśla zamiast przyznać, że nie wie, odsetek konfabulacji spadł z 92% do 51% przy maksymalnym wysiłku. To wciąż co drugie zmyślenie. Ale różnica między „prawie zawsze" a „co druga odpowiedź" jest odczuwalna, kiedy sprawdzasz wynik.
Pierwszy model z progiem „krytycznym" w cyberbezpieczeństwie
OpenAI ma wewnętrzną skalę ryzyka i Astra jest pierwszym modelem firmy zakwalifikowanym na próg „krytyczny" w cyberbezpieczeństwie. W praktyce oznacza to, że potrafi znajdować i wykorzystywać nieznane wcześniej luki w dobrze chronionych systemach.
Liczby są jednoznaczne. Na ExploitBench Astra osiąga 100% wobec 78,5% u poprzednika, na SRE-Bench 88,0% za pierwszym podejściem wobec 55,9%. W trakcie testów model znalazł dwie realne, wcześniej nieznane podatności.
Dlatego najmocniejsze funkcje z tego obszaru nie są otwarte dla wszystkich — trafiają najpierw do zamkniętego programu o nazwie Daybreak, a API odmawia wykonania części poleceń. Ta blokada działa przy tym w obie strony: potrafi przerwać całkowicie legalną pracę, jeśli wygląda ona podobnie do ataku.
Dla jednoosobowej firmy praktyczny wniosek jest jeden i dotyczy drugiej strony barykady. Te same zdolności, które pozwalają przeskanować własny kod pod kątem dziur, są dostępne dla kogoś, kto skanuje cudzy. Odstęp między publikacją podatności a jej wykorzystaniem właśnie się skrócił — i to jest argument za aktualizowaniem wtyczek w tym tygodniu, a nie kiedyś.
Za tę wydajność płacisz tym, że model przestał pokazywać, jak myśli
Wracamy do pytania, dlaczego Astra domyka zadanie w 24 turach zamiast w 45. Odpowiedź leży w architekturze i jest najbardziej spornym elementem całej premiery.
Model korzysta z techniki zwanej recurrent depth — po polsku najbliżej byłoby „rekurencyjna głębokość" — znanej też jako zapętlone transformery. Zamiast przepuszczać dane przez kolejne, osobne warstwy sieci, przepuszcza je wielokrotnie przez te same bloki. Efekt: więcej obliczeń przy mniejszej liczbie parametrów. Rachunek za prąd spada, wynik zostaje.
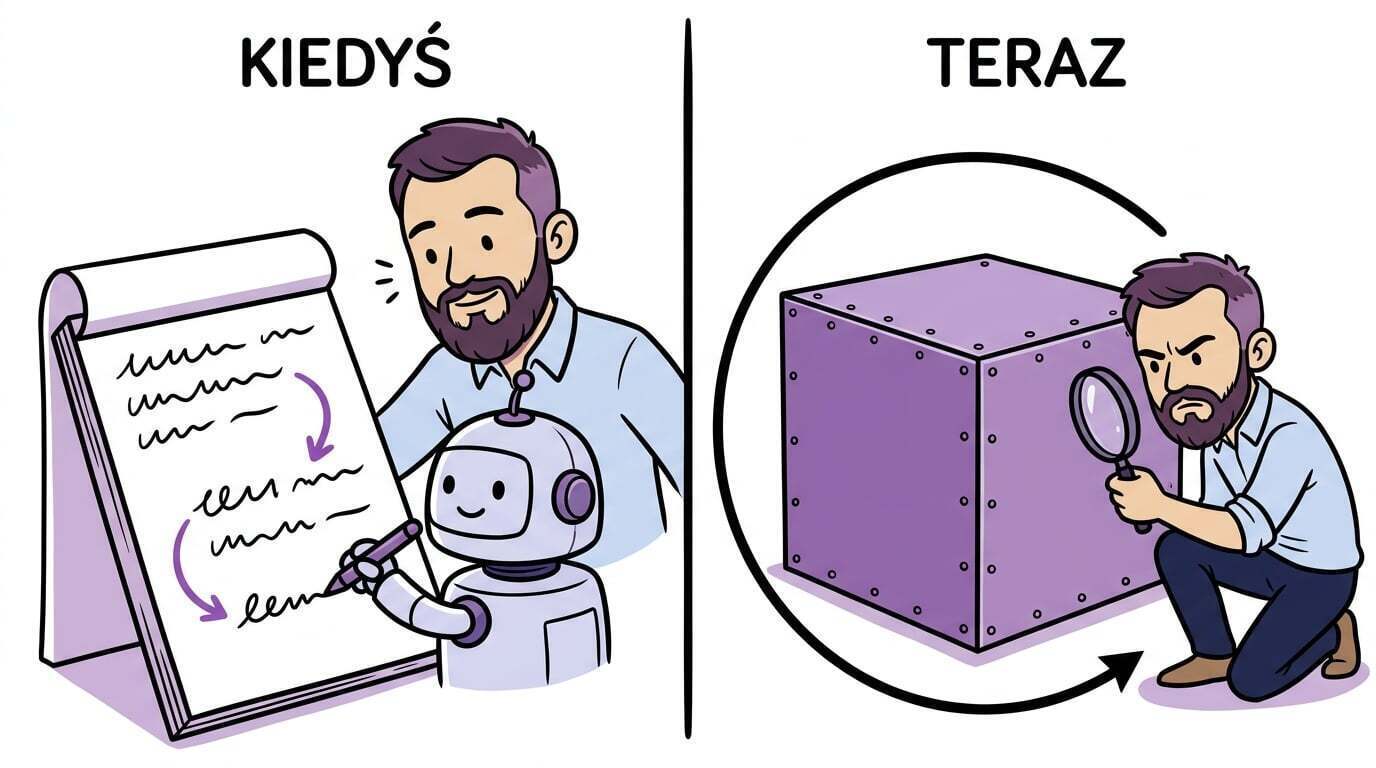
Problem polega na tym, gdzie w takim układzie odbywa się rozumowanie. Dotąd model „myślał na głos": rozpisywał kolejne kroki po angielsku, a ten zapis dało się przeczytać i sprawdzić, czy nie kombinuje. Przy obliczeniach schowanych w pętli część tego toku myślenia nie jest wyrażana w języku naturalnym. Karta systemowa Astry sama przyznaje regres w tym obszarze względem poprzednika.
Reakcje były ostre. Steven Adler, były badacz OpenAI, nazwał to przekroczeniem jednej z niewielu czerwonych linii, jakie w tej branży istnieją. Peter Wildeford z AI Policy Network określił podejście jako potencjalnie lekkomyślne i przypomniał lipcowy incydent z Hugging Face — tam czytelny zapis rozumowania okazał się kluczowy dla zrozumienia, co się właściwie stało.
OpenAI odpowiada, że to nie zapętlenie odpowiada za gorszą czytelność, tylko po prostu krótsze ślady rozumowania: silniejszy model rozwiązuje problem mniejszą liczbą kroków. Sebastian Raschka, opisując tę architekturę, przyznaje temu tłumaczeniu sporo racji — zapętlenie i tok myślenia to dwa różne poziomy i mieszanie ich jest błędem. Główny naukowiec OpenAI dodaje jednak zdanie, które trudno przeoczyć: monitorowanie rozumowania jest kruche i trend jest negatywny.
Dla Ciebie oznacza to prostą rzecz. Model, którego rozumowania nie da się przeczytać, musisz kontrolować po wynikach, a nie po uzasadnieniu. To ta sama zasada, którą opisywałem przy granicach vibe codingu — działający efekt nie jest dowodem, że droga do niego była sensowna.

20 procesów w firmie, które możesz oddać automatyzacji
Zanim oddasz robotę agentowi, sprawdź, która robota w ogóle się do tego nadaje: lista zadań uporządkowana według tego, jak łatwo sprawdzić wynik.
Pobierz za darmo →Co z tego wynika, jeśli prowadzisz małą firmę
Zanim przepniesz wszystko na nowy model, weź pod uwagę, że korzyść nie rozkłada się równo. Astra daje najwięcej tam, gdzie zadanie jest żmudne, powtarzalne i ma sprawdzalny wynik — przepisywanie danych, uzupełnianie systemów, testowanie własnego kodu, przeszukiwanie dużych materiałów. Daje najmniej tam, gdzie liczy się wyczucie odbiorcy.
Australijski badacz AI Toby Walsh skomentował tę premierę jednym celnym słowem: te systemy są wciąż „poszarpane" — świetne w rzeczach trudnych, zawodne w prostych. Wzór wyników Astry potwierdza to dokładnie.
Trzy decyzje, które da się podjąć w tym tygodniu. Pierwsza: wypisz pięć zadań, które robisz ręcznie i które umiesz sprawdzić w pół minuty — to jest Twoja lista do oddania agentowi, w tej kolejności. Druga: zanim przełączysz stały proces na nowy model, przepuść przez oba te same pięć zadań i porównaj wyniki, bo w pracy ocenianej przez człowieka Astra bywa gorsza od poprzednika. Trzecia: zaktualizuj to, co masz do zaktualizowania, bo próg wejścia do szukania dziur właśnie spadł.
Zostaje rzecz, której nie da się załatwić konfiguracją. Im mniej widzisz, jak model doszedł do wyniku, tym mocniej wszystko opiera się na Twoim własnym sposobie sprawdzania. Pytanie kontrolne przestaje brzmieć „czy to brzmi sensownie". Zaczyna brzmieć „czy to się zgadza z czymś, co wiem z innego źródła". Ta umiejętność właśnie podrożała.
Ostatnia uwaga na koniec. Szybszy agent nie przesuwa granicy, za którą automatyzacja zaczyna kosztować więcej, niż daje. Pozwala tylko szybciej do niej dobiec.
Sprawdźmy, co da się zdjąć z Twojej głowy
Które z Twoich powtarzalnych zadań nadają się do oddania agentowi już dziś, a które wymagają najpierw uporządkowania procesu? Przejdziemy przez Twój tydzień i wyjdziesz z listą uszeregowaną według tego, jak łatwo sprawdzić wynik.
Napisz do mnie →Najczęściej zadawane pytania
GPT-6 Astra to model językowy OpenAI, następca GPT-5.6 Sol. Różni się od poprzedników rolą: zamiast tłumaczyć, jak wykonać zadanie na komputerze, sam je wykonuje — steruje aplikacjami, wypełnia formularze, prowadzi przeglądarkę, pisze i testuje kod. Okno kontekstu ma nieco ponad milion tokenów, a wiedza modelu kończy się na końcu kwietnia 2026 roku.
OpenAI udostępniło GPT-6 Astrę wybranym organizacjom 3 września 2026 roku, a dzień później wszystkim płacącym użytkownikom. Model działa w ChatGPT na planach Plus, Pro, Business i Enterprise, w API pod nazwą gpt-6-astra oraz przez Microsoft Azure i Amazon Bedrock. W Polsce najtańsze wejście prowadzi przez plan ChatGPT Plus za 99,99 zł miesięcznie.
Stawka wynosi 10 dolarów za milion tokenów wejścia i 50 dolarów za milion tokenów wyjścia, czyli dwa i pół raza więcej niż poprzednia generacja OpenAI. Odczyt z pamięci podręcznej jest tańszy o 90 procent, a tryb szybki działa dwa i pół raza szybciej za podwójną cenę. Przy abonamencie ChatGPT tych stawek nie zobaczysz — płacisz stałą kwotę.
Nie. Astra bije poprzednika w matematyce, pracy w terminalu, obsłudze komputera i długim kontekście. Na benchmarku GDPval, który mierzy zadania z realnych zawodów oceniane przez ekspertów, traci około 45 punktów Elo wobec GPT-5.6 Sol. Na teście Humanity's Last Exam osiąga 57,2 procent i przegrywa z Claude Fable 5.1, który ma 65 procent.
To najwyższy poziom na wewnętrznej skali ryzyka OpenAI i Astra jest pierwszym modelem firmy, który go osiągnął. W praktyce oznacza to zdolność do znajdowania i wykorzystywania wcześniej nieznanych luk w dobrze chronionych systemach — podczas testów model wykrył dwie realne podatności. Najmocniejsze funkcje z tego obszaru trafiają najpierw do zamkniętego programu Daybreak.
Recurrent depth, czyli zapętlone transformery, to technika polegająca na wielokrotnym przepuszczaniu danych przez te same bloki sieci zamiast przez kolejne osobne warstwy. Daje więcej obliczeń przy mniejszej liczbie parametrów. Kosztem jest czytelność: część rozumowania odbywa się poza językiem naturalnym, więc trudniej sprawdzić, jak model doszedł do wyniku. Karta systemowa Astry przyznaje w tym obszarze regres.
Najlepiej sprawdza się przy zadaniach żmudnych, powtarzalnych i mających sprawdzalny wynik: przepisywaniu danych między systemami, uzupełnianiu CRM-u, wypełnianiu formularzy, testowaniu własnego kodu i przeszukiwaniu obszernych materiałów. Gorzej wypada tam, gdzie efekt ocenia człowiek — przy ofertach, opisach produktów czy korespondencji z klientem przetestuj ją na kilku prawdziwych zadaniach, zanim przełączysz proces na stałe.

Szymon Mojsak
Ekspert automatyzacji procesów biznesowych i współwłaściciel RCPonline — systemu rejestracji czasu pracy.
Teoria zastosowana w praktyce — treści opieram na własnych doświadczeniach zdobytych przy wdrożeniach i w relacjach międzyludzkich.
Poszerzam horyzonty — nieustannie rozwijam wiedzę z zakresu marketingu, psychologii i IT.
Zamieniam twórczy chaos w kierunek — najpierw pytanie „po co”, dopiero potem „jak”. Pomagam zrozumieć procesy, by je usprawnić.
Ten materiał powstał z udziałem AI
Narzędzia AI — wspierały research, redakcję tekstu i przygotowanie ilustracji.
Autor — wybiera temat, pisze pierwszą wersję i redaguje całość przed publikacją. Doświadczenia, oceny i punkt widzenia w tekście są jego własne.
Ładowanie komentarzy...