

Czyli o tym, dlaczego powiadomienie o błędzie nie wystarczy, kiedy scenariusz po prostu przestaje się odzywać.
Koniec kwartału. Siadasz do podsumowania i coś się nie zgadza: zapytań ze strony jest mniej niż zwykle. Dużo mniej, więc otwierasz CRM i przewijasz listę leadów. Ostatni, który wpadł z formularza kontaktowego, ma datę z początku lipca. Wchodzisz na stronę i wysyłasz testowe zgłoszenie: formularz dziękuje, a mail z potwierdzeniem przychodzi bez problemu. Do CRM nie trafia nic, a handlowiec nie dostaje powiadomienia, tak jak nie dostawał go od trzech miesięcy.
Sprawdzasz skrzynkę i nie znajdujesz ani jednego maila o błędzie, a panel automatyzacji też nie pokazuje nic czerwonego.
Nic się nie zepsuło. Po prostu nic się nie działo.
Brzmi znajomo? Tak wygląda cicha awaria: stan, w którym automatyzacja przestaje dostarczać to, po co ją zbudowano, i nie zgłasza przy tym żadnego błędu. Nie ma czego naprawiać po alarmie, bo alarmu nie było. Zwykle pierwszym sygnałem jest telefon od klienta albo dziura w raporcie, która wychodzi po tygodniach. A przecież alarm był ustawiony. Pilnował jednak czegoś innego, niż Ci się wydawało.
Powiadomienie o błędzie słyszy tylko awarie, które krzyczą
Najpopularniejsza rada przy automatyzacjach brzmi: ustaw powiadomienia o błędach. To dobra rada, tylko ma ukryte założenie, o którym rzadko się mówi. Powiadomienie zadziała wtedy, gdy scenariusz się uruchomił, doszedł do jakiegoś kroku i na nim się wywrócił. Wtedy jest wykonanie, jest błąd i jest o czym powiadomić.
W n8n służy do tego osobny scenariusz błędów, zaczynający się od węzła Error Trigger. Dokumentacja n8n mówi o nim wprost: uruchamia się, gdy wykonanie zakończy się porażką. W opisie samego węzła pada drugie zdanie, które łatwo przeoczyć: Error Trigger działa tylko wtedy, gdy błąd wystąpi w automatycznym uruchomieniu. Ręcznego testu nim nie sprawdzisz.
Wynika z tego coś prostego, a mimo to zaskakującego. Jeśli scenariusz się nie uruchomił, nie ma wykonania. Nie ma wykonania, nie ma porażki. Nie ma porażki, alarm śpi. Mechanizm działa dokładnie tak, jak go zaprojektowano, i dokładnie dlatego przegapi najgorszy przypadek.
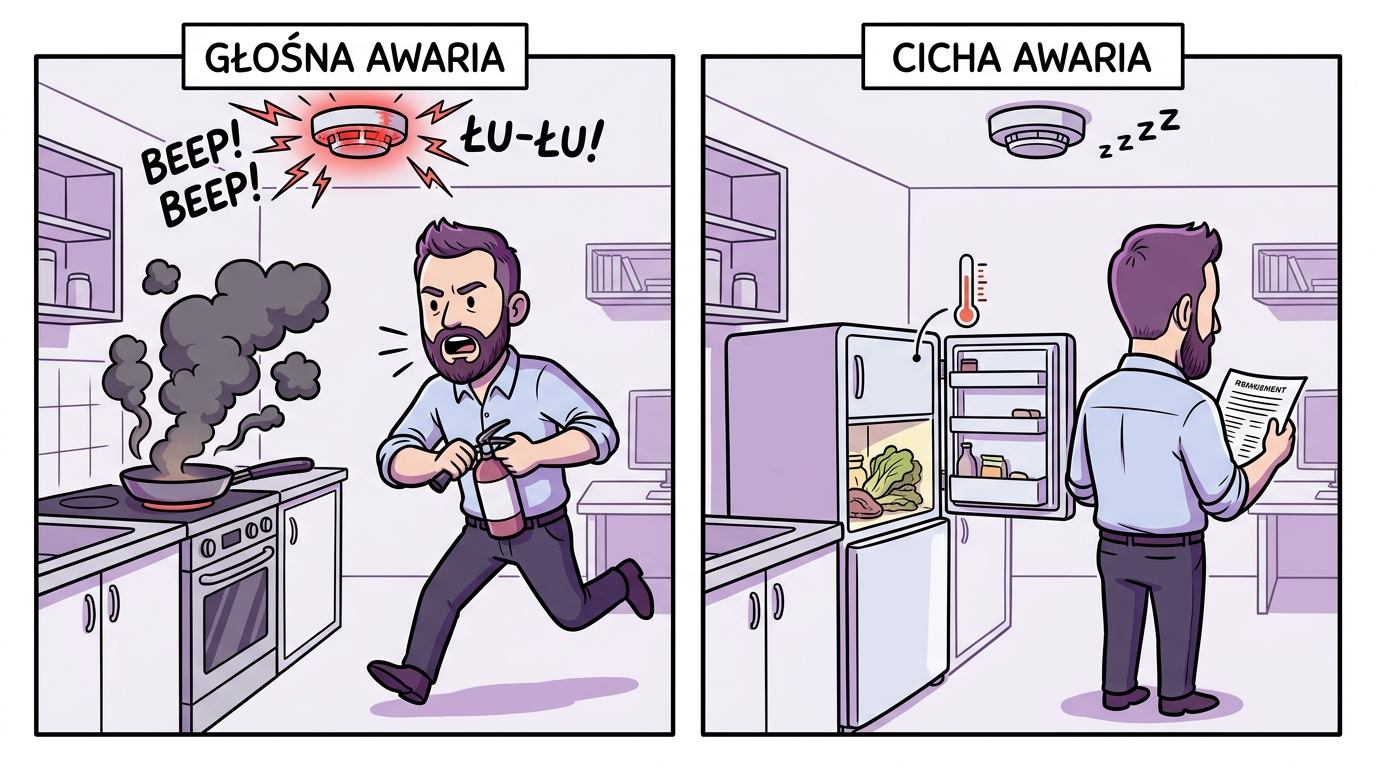
To trochę jak czujnik dymu w biurowej kuchni. Przypalona patelnia? Wyje tak, że słychać na korytarzu. Lodówka, która od tygodnia nie chłodzi? O niej czujnik nie ma pojęcia, bo lodówka nie dymi, tylko po cichu się nagrzewa. Dowiesz się, kiedy ktoś otworzy jogurt.
Cztery sposoby, na jakie scenariusz milknie
Awaria, która krzyczy, to tylko jedna z możliwości. W scenariuszach, które oglądałem w małych firmach, cisza ma zwykle jedną z czterech postaci. Tylko pierwszą widać w panelu jako coś czerwonego.
| Co się dzieje | Co widzisz w panelu | Czy alarm o błędzie zadzwoni |
|---|---|---|
| Scenariusz rusza i wywraca się na jednym z kroków | Czerwone wykonanie z treścią błędu | Tak, po to go ustawiłeś |
| Scenariusz w ogóle się nie uruchamia: wyłączony, wyzwalacz nie dostaje zdarzeń, serwer akurat spał | Nic. Brak nowych wykonań nie wygląda jak błąd | Nie |
| Scenariusz rusza, ale nie dostaje danych: zmieniona nazwa kolumny, filtr, który odrzuca wszystko | Zielone wykonanie, tylko krótsze niż zwykle | Nie |
| Alarm pada razem ze scenariuszem: to samo wygasłe połączenie, skrzynka, której nikt nie czyta | Zależy od miejsca, w którym patrzysz. Zwykle nic | Nie, bo to on jest zepsuty |
Najmniej intuicyjny jest trzeci wiersz. W n8n węzeł, który nie zwrócił żadnych danych, domyślnie nie przekazuje niczego dalej. Dokumentacja opisuje ustawienie Always Output Data jako sposób, żeby kolejne węzły ruszyły mimo pustego wyniku. Bez niego ścieżka po prostu się kończy. Bez błędu, bo z punktu widzenia programu nic złego się nie stało: przyszło zero rekordów, więc nie było czego przetwarzać.
Dla Ciebie to zero jest całym problemem. Formularz zmienił nazwę pola z „email” na „adres e-mail”, filtr szuka starej nazwy, więc odrzuca każde zgłoszenie. Scenariusz codziennie przechodzi na zielono i robi tak od trzech miesięcy.
Platforma potrafi wyłączyć scenariusz za Ciebie
Drugi wiersz tabeli, czyli scenariusz, który się nie uruchamia, ma jeszcze jedną przyczynę, o której mało kto wie, dopóki nie trafi na nią sam. Część platform wyłącza scenariusz automatycznie, kiedy uznają, że jest zepsuty.
Zapier opisuje to w swojej pomocy: Zap zostaje wyłączony, jeśli w ciągu ostatnich 7 dni miał ponad 20 uruchomień i 95% z nich kończyło się błędem. Ma to sens, bo nikt nie chce scenariusza, który przez tydzień produkuje wyłącznie błędy. Haczyk siedzi w tym samym artykule. Mail ostrzegający o wyłączeniu, z dobą lub trzema dobami zapasu, dostają właściciele kont w planach Team i Enterprise. O powiadomieniu dla pozostałych planów tekst milczy.
Przez tydzień alarm o błędach wysyła maile, a Ty je przeglądasz i odkładasz „na później”. Potem scenariusz zostaje wyłączony i maile ustają. Cisza wygląda jak naprawa.
Ten wzorzec jest szerszy niż jedno narzędzie. Wszędzie, gdzie scenariusz można wyłączyć (Ty, współpracownik przy porządkach, sama platforma), istnieje stan, w którym nic nie działa i nic nie zgłasza błędu. Zmiana statusu z „włączony” na „wyłączony” nie jest awarią w rozumieniu żadnego systemu powiadomień.
Nadawca czeka na Ciebie trzy dni, nie trzy miesiące
Duża część automatyzacji w małej firmie zaczyna się od webhooka: sklep, system płatności albo formularz wysyła wiadomość pod adres Twojego scenariusza w chwili, gdy coś się wydarzy.
📖 Ze słownika Noraline: Webhook — adres, pod który inny system sam wysyła dane w momencie zdarzenia, zamiast czekać, aż ktoś o nie zapyta. Wygodny, bo działa od razu. Kłopotliwy, bo jeśli adres przestanie odpowiadać, Twoja strona nie wie nawet, że coś miało przyjść.
Przy webhookach cicha awaria zaczyna się często od zwykłej przeprowadzki: n8n przechodzi na nowy serwer albo domenę, scenariusz dostaje nowy adres, a w panelu sklepu zostaje stary. Po Twojej stronie nie dzieje się nic, bo nic do Ciebie nie dociera. Błędy widzi wyłącznie nadawca, w swoim panelu, do którego zaglądasz raz na pół roku.
Nadawcy zwykle ponawiają próby, ale nie bez końca. Stripe opisuje to precyzyjnie: w trybie produkcyjnym ponawia doręczenie zdarzenia przez maksymalnie trzy dni, z coraz dłuższymi przerwami. Ręcznie zdarzenie da się wysłać ponownie z panelu do 15 dni od jego utworzenia, a z linii poleceń do 30. Co dalej? Trzy miesiące po awarii nie ma już czego ponawiać. Dane trzeba odtwarzać z innego źródła, o ile takie istnieje.
Cicha awaria kosztuje więc podwójnie: najpierw to, co przez ten czas nie działało, a potem to, czego po kilku dniach nie da się już nadrobić.
Zadanie, które padło w dwie sekundy, system uznał za wykonane
Cicha awaria nie wymaga ani zepsutego połączenia, ani nieuważnego człowieka. Wpisy na trzy firmowe blogi przygotowuje u mnie automat uruchamiany o stałej godzinie przez harmonogram systemowy macOS (launchd). Harmonogram ma przydatną cechę: jeśli komputer spał w chwili, gdy zadanie miało ruszyć, nadrobi je po wybudzeniu.
28 sierpnia 2026 laptop zasnął kilkanaście minut przed porą uruchomienia. Dokładnie o tej porze system na moment się wybudził, ale bez sieci. Zadanie ruszyło, sprawdzenie połączenia z serwerem padło w niecałą sekundę, a dwie sekundy później maszyna znów spała. Dla harmonogramu zadanie się wykonało: wystartowało i zakończyło się. Nie ma powodu niczego nadrabiać. Wpis tego dnia nie powstał i nic tego samo nie naprawiło.
Nie zawiódł żaden scenariusz. Zawiodło założenie, że „zadanie się wykonało” znaczy to samo co „zadanie zrobiło swoje”. Poprawka odwróciła pytanie. Co pół godziny osobny skrypt sprawdza, czy po dzisiejszym terminie istnieje zapis udanego runu. Jeśli go nie ma, uruchamia zadanie jeszcze raz, maksymalnie trzy razy na dobę.
Ta sama zasada siedzi w samym automacie: run, który nie zostawi pliku z wynikiem, liczy się jako nieudany, cokolwiek twierdzi w logach. Milczenie nie jest dowodem sukcesu.
Mierz efekt, nie brak błędów
Inżynierowie Google doszli do tego samego wniosku w skali, o jakiej mała firma nie musi myśleć. W rozdziale o monitorowaniu z książki Site Reliability Engineering dzielą sygnały na objawy (co nie działa) i przyczyny (dlaczego). Rekomendacja jest jednoznaczna: znacznie więcej wysiłku warto włożyć w wyłapywanie objawów niż przyczyn.
Przełożone na automatyzacje: błąd wykonania to przyczyna, i to tylko jedna z wielu. Objaw to „od wczoraj do CRM nie wpadł żaden lead” albo „klienci nie dostają potwierdzeń”. Objaw obejmuje wszystkie cztery wiersze z tabeli naraz, bo nie obchodzi go, dlaczego wyniku nie ma. Interesuje go tylko, że go nie ma.
Pisałem już o tym, ile kosztuje utrzymanie scenariuszy po roku w Make, n8n i Zapierze, i o trzech nawykach, które to utrzymanie obcinają: właścicielu z imienia, alarmie na komunikatorze i rejestrze połączeń. Tamten tekst odpowiada na pytanie, kto i za ile pilnuje scenariuszy. Ten dotyczy czegoś węższego: jak w ogóle zauważyć, że jest czego pilnować, kiedy żaden alarm się nie odzywa. A pułapka automatyzacji zaczyna się jeszcze wcześniej, przy decyzji, czy w ogóle coś automatyzować. Ten wpis zakłada, że decyzja zapadła i scenariusz już działa.
Alarm, który dzwoni, gdy jest za cicho
Narzędzie do pilnowania objawów ma swoją nazwę. Po angielsku to dead man's switch, czyli wyłącznik czuwakowy, znany z kabin maszynistów: urządzenie zakłada, że coś jest nie tak, jeśli przez określony czas nie dostanie sygnału, że wszystko w porządku. W świecie automatyzacji mówi się też o monitorowaniu sygnału życia (heartbeat).
Działa to prosto. Na końcu scenariusza, po kroku, który robi właściwą robotę, dodajesz jedno zapytanie HTTP pod adres usługi monitorującej. Usługa wie, jak często ten sygnał powinien przychodzić. Dopóki sygnał przychodzi, usługa milczy, a kiedy przestaje przychodzić, wysyła alarm. Dokumentacja Healthchecks.io, jednej z takich usług, opisuje to dwoma parametrami: okresem i czasem karencji. Przy okresie godziny i pięciu minutach karencji sygnał z 12:00 oznacza, że o 13:00 usługa uznaje spóźnienie, a o 13:05 wysyła alarm.
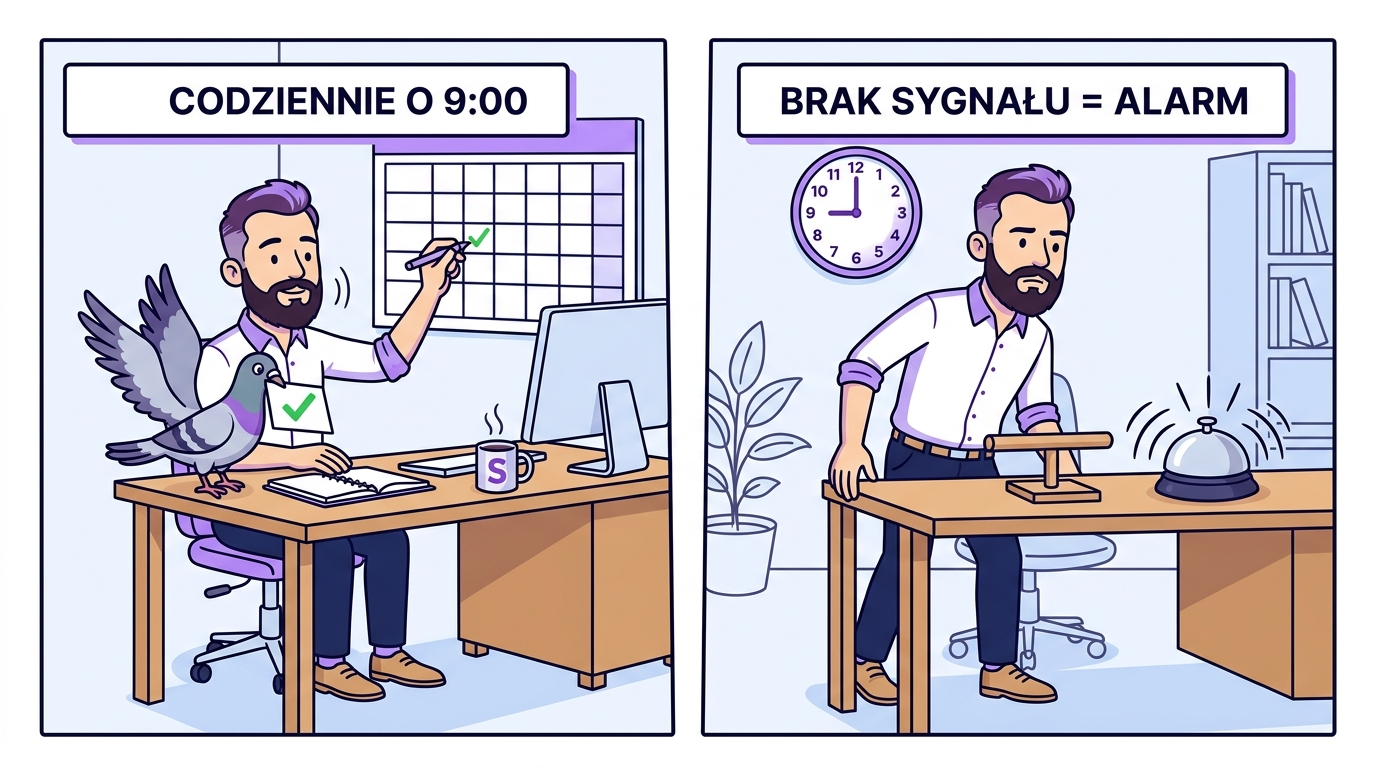
Cała siła tego rozwiązania polega na kierunku. Alarm o błędzie potrzebuje, żeby coś się wydarzyło. Sygnał życia potrzebuje, żeby coś się nie wydarzyło. Scenariusz wyłączony, niewyzwolony, zatrzymany na pustym filtrze albo uśpiony razem z serwerem nie wyśle sygnału. Dokładnie ten brak zostanie zauważony przez usługę monitorującą.
Jest jeden warunek. Sygnał musi wychodzić z miejsca, do którego scenariusz dochodzi tylko wtedy, gdy zrobił swoje, czyli po zapisie do CRM, a nie zaraz po wyzwalaczu. Sygnał wysłany na starcie powie Ci tylko, że scenariusz ruszył.
Liczba, która powinna być większa od zera
Sygnał życia sprawdza się przy scenariuszach uruchamianych regularnie, na przykład co godzinę albo codziennie rano. Gorzej z tymi, które reagują na zdarzenia. Formularz kontaktowy nie wysyła zgłoszeń co godzinę, więc brak sygnału przez trzy godziny w niedzielę o niczym nie świadczy.
Tu lepiej działa drugi rodzaj kontroli: osobny, mały scenariusz uruchamiany codziennie, który liczy efekt. Ile leadów z formularza trafiło wczoraj do CRM? Ile faktur wyszło? Ile potwierdzeń zamówień wysłano? Jeśli liczba wynosi zero w dniu, w którym zwykle wynosi kilka, scenariusz kontrolny celowo kończy się błędem.
W n8n jest do tego gotowy węzeł Stop and Error, który według dokumentacji pozwala wymusić porażkę wykonania w wybranych przez Ciebie okolicznościach i przekazać własny komunikat do scenariusza błędów. Wtedy cisza zamienia się w błąd, a błąd trafia tam, gdzie i tak już trafiają pozostałe alarmy.
Nie ustawiaj progu na sztywno „poniżej 5”. Zacznij od „zero w dzień roboczy”. Taki alarm prawie nigdy nie dzwoni fałszywie, a łapie każdą z czterech cichych awarii.
Liczenie efektu ma jeszcze jedną zaletę, której sygnał życia nie daje. Sprawdza cały łańcuch, łącznie z kawałkami, których nie kontrolujesz. Jeśli sklep przestał wysyłać webhooki, Twój scenariusz nie zaraportuje żadnego błędu, ale licznik zamówień w CRM pokaże zero.
Jak to poukładać w jedno popołudnie
Nie musisz pilnować wszystkiego. Większość scenariuszy w małej firmie to drobiazgi, których awaria nikogo nie zaboli. Zacznij od tych, przy których cisza kosztuje klientów albo pieniądze.
Ostatni krok jest najczęściej pomijany, a odpowiada na czwarty wiersz tabeli. Scenariusz błędów korzysta z połączeń, które też wygasają, i wysyła wiadomości na kanał, który ktoś kiedyś wyciszył. Pilnujący też potrzebuje kogoś, kto sprawdzi, czy nie zasnął.
Jeśli chcesz to zbudować krok po kroku, w kursie automatyzacji w n8n z AI jest osobny rozdział o utrzymaniu: monitoringu, logach i powiadomieniach z treścią błędu. Jeśli dopiero wybierasz platformę, zacznij od tego, kiedy n8n ma sens zamiast Make albo Zapiera.
Automatyzacja, która się psuje, nie jest największym zagrożeniem. Taka przynajmniej daje znać. Groźniejsza jest ta, która milknie i czeka, aż ktoś zauważy, że czegoś brakuje. Dlatego przy każdej ważnej automatyzacji warto znać dwie odpowiedzi: gdzie powinien pojawić się jej efekt i co sprawdza, czy się pojawił.
Sprawdźmy, co da się zdjąć z Twojej głowy
Które z Twoich automatyzacji mogłyby dziś milczeć, a Ty byś o tym nie wiedział? Przejdziemy razem przez listę scenariuszy, wskażę te, przy których cisza kosztuje najwięcej, i ustawimy dla nich kontrolę efektu.
Napisz do mnie →Najczęściej zadawane pytania
To sytuacja, w której scenariusz automatyzacji przestaje dostarczać efekt, na przykład leady nie trafiają do CRM albo klienci nie dostają potwierdzeń, a żaden system nie zgłasza błędu. Najczęściej scenariusz w ogóle się nie uruchamia, uruchamia się bez danych i kończy na zielono albo psuje się razem z mechanizmem, który miał powiadamiać o błędach. Zwykle wychodzi to dopiero po tygodniach, przy raporcie albo telefonie od klienta.
Scenariusz błędów zaczynający się od węzła Error Trigger uruchamia się wtedy, gdy automatyczne wykonanie innego scenariusza zakończy się porażką. Jeśli scenariusz w ogóle nie ruszył, bo został wyłączony, wyzwalacz nie dostał zdarzenia albo serwer był niedostępny, nie ma wykonania, więc nie ma też porażki. Podobnie jest, gdy wykonanie przechodzi poprawnie, ale z zerową liczbą rekordów. Takich przypadków alarm o błędzie nie zobaczy.
To alarm działający odwrotnie niż zwykłe powiadomienie o błędzie. Scenariusz po wykonaniu właściwej pracy wysyła krótki sygnał, na przykład zapytanie HTTP do usługi monitorującej. Usługa wie, jak często sygnał powinien przychodzić, i alarmuje dopiero wtedy, gdy przestaje przychodzić. Dzięki temu wyłapuje scenariusze wyłączone, niewyzwolone albo zatrzymane na pustych danych. Przykładem takiej usługi jest Healthchecks.io z parametrami okresu i czasu karencji.
Na końcu, po kroku, który wykonuje właściwą robotę, na przykład po zapisie leada do CRM albo wysłaniu faktury. Sygnał wysłany zaraz po wyzwalaczu potwierdza tylko, że scenariusz wystartował, a nie że zrobił to, po co go zbudowano. Okres monitoringu ustaw na częstotliwość uruchomień, a czas karencji na typowy czas wykonania z zapasem, żeby uniknąć fałszywych alarmów.
Przy scenariuszach reagujących na zdarzenia, takich jak formularz kontaktowy czy zamówienie w sklepie, lepiej działa dzienny licznik efektu. Osobny scenariusz uruchamiany rano sprawdza, ile rekordów powstało poprzedniego dnia, na przykład leadów w CRM. Jeśli w dzień roboczy wynik wynosi zero, scenariusz kontrolny kończy się celowo błędem, w n8n węzłem Stop and Error, a ten błąd trafia do zwykłego kanału alarmów.
Tak. Według pomocy Zapiera Zap zostaje wyłączony automatycznie, jeśli w ciągu ostatnich siedmiu dni miał ponad 20 uruchomień, a 95% z nich zakończyło się błędem. Mail ostrzegający przed wyłączeniem, z dobą lub trzema dobami zapasu, dostają właściciele kont w planach Team i Enterprise. Po wyłączeniu maile o błędach ustają, więc cisza w skrzynce może wyglądać jak naprawa, choć scenariusz w ogóle nie działa.
To zależy od usługi. Stripe w trybie produkcyjnym ponawia doręczenie zdarzenia przez maksymalnie trzy dni, z coraz dłuższymi przerwami. Ręcznie można je wysłać ponownie z panelu do 15 dni od utworzenia, a z linii poleceń do 30 dni. Jeśli awaria adresu webhooka trwa miesiącami, zdarzeń z tego okresu nie da się już po prostu ponowić i dane trzeba odtwarzać z innego źródła.

Szymon Mojsak
Ekspert automatyzacji procesów biznesowych i współwłaściciel RCPonline — systemu rejestracji czasu pracy.
Teoria zastosowana w praktyce — treści opieram na własnych doświadczeniach zdobytych przy wdrożeniach i w relacjach międzyludzkich.
Poszerzam horyzonty — nieustannie rozwijam wiedzę z zakresu marketingu, psychologii i IT.
Zamieniam twórczy chaos w kierunek — najpierw pytanie „po co”, dopiero potem „jak”. Pomagam zrozumieć procesy, by je usprawnić.
Ten materiał powstał z udziałem AI
Narzędzia AI — wspierały research, redakcję tekstu i przygotowanie ilustracji.
Autor — wybiera temat, pisze pierwszą wersję i redaguje całość przed publikacją. Doświadczenia, oceny i punkt widzenia w tekście są jego własne.
Ładowanie komentarzy...