

Czyli o tym, dlaczego najdroższa pomyłka modelu to ta, przy której nic Ci nie zgrzytnęło.
Piszesz ofertę dla klienta i brakuje Ci jednego zdania z twardymi danymi. Prosisz model językowy, żeby znalazł statystykę, która pokaże, że Twoja usługa się opłaca. Po chwili dostajesz akapit z nazwą znanej firmy badawczej, rokiem publikacji i procentem, który podpiera Twoją tezę lepiej, niż sam byś to ujął. Brzmi rzeczowo. Pasuje. Wklejasz.
Dwa tygodnie później klient prosi o link do raportu. Raport istnieje. Tej liczby w nim nie ma.
Gdyby model napisał, że stolicą Niemiec jest Warszawa, wyłapałbyś to w pół sekundy. Tamten akapit nie miał jednak w sobie niczego, o co mogłoby się potknąć oko. Był dokładnie taki, jakiego się spodziewałeś. Brzmi znajomo?
To jest halucynacja AI, czyli sytuacja, w której model podaje nieprawdę tym samym pewnym tonem co prawdę. Większość tekstów o halucynacjach pokazuje wpadki śmieszne i absurdalne, bo te dobrze się udostępnia. Groźniejsza jest druga odmiana: błąd, który przechodzi przez kontrolę właśnie dlatego, że zgadza się z Twoimi oczekiwaniami. Takie błędy kosztują realne pieniądze. W 2025 roku Deloitte zgodził się oddać australijskiemu rządowi część z około 440 tysięcy dolarów australijskich za raport, w którym znalazły się odwołania do nieistniejących prac naukowych i zmyślony cytat z wyroku sądu. Nikt z autorów tego nie zauważył, bo przypisy wyglądały jak przypisy.
Absurdalną halucynację wyłapiesz sam, wiarygodnej prawie nigdy
Kontrola tekstu, który dostajesz od modelu, działa nierówno. Czytając, szukasz sprzeczności z tym, co już wiesz. Zdanie, które się z Twoją wiedzą kłóci, zapala lampkę. Zdanie, które się z nią zgadza, przelatuje bez zatrzymania, bo mózg nie ma powodu, żeby je sprawdzać.
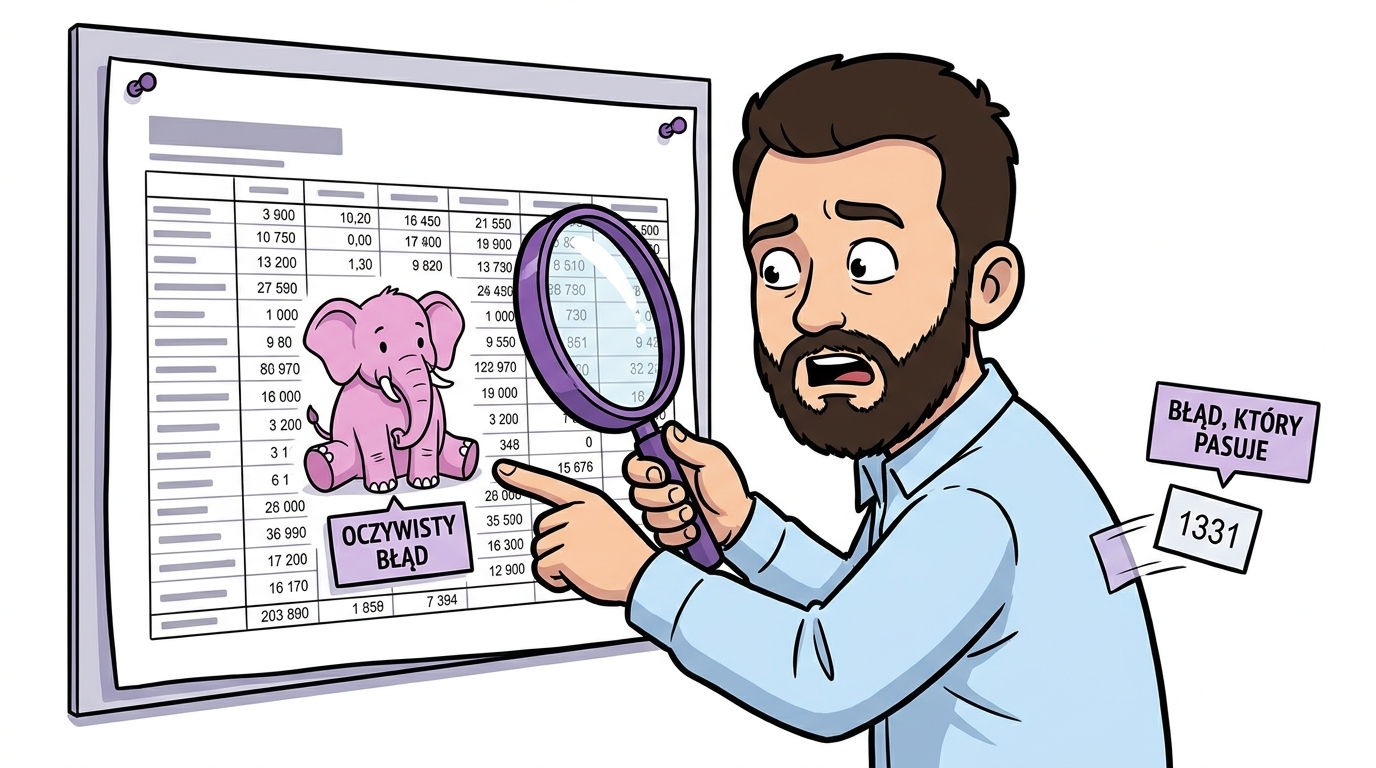
To nie jest wada charakteru. Psychologia zna ten mechanizm od dawna i ma na niego dwie nazwy. Pierwsza to efekt potwierdzenia, czyli skłonność do łatwiejszego przyjmowania informacji zgodnych z tym, co już sądzimy. Druga dotyczy pracy z maszynami.
Ze słownika Noraline: błąd automatyzacji (automation bias) to skłonność do przyjmowania wyniku systemu bez sprawdzenia, nawet wtedy, gdy inne sygnały mu przeczą. Raja Parasuraman i Dietrich Manzey w przeglądzie badań z 2010 roku pokazali, że ulegają mu zarówno nowicjusze, jak i doświadczeni specjaliści, a samo szkolenie go nie usuwa.
Złóż oba efekty razem i masz przepis na wpadkę. Model mówi pewnym tonem, odpowiedź zgadza się z tym, czego szukałeś, a Ty masz na biurku jeszcze dziesięć innych rzeczy. Stąd najgroźniejszy błąd modelu to ten zgodny z tym, czego się spodziewałeś, a nie ten absurdalny. Żeby go wyłapać, trzeba wiedzieć, skąd się bierze.
Model zgaduje, bo nauczono go zdawać egzaminy
We wrześniu 2025 roku badacze OpenAI opublikowali pracę „Why Language Models Hallucinate”, w której tłumaczą zjawisko porównaniem do ucznia na teście jednokrotnego wyboru. Puste pole daje zero punktów. Strzał daje szansę na punkt. Uczeń, który zawsze zgaduje, wypada w rankingu lepiej od ucznia, który uczciwie przyznaje się do niewiedzy.
Według autorów większość testów, na których porównuje się modele, ocenia je dokładnie w ten sposób. Odpowiedź „nie wiem” jest punktowana tak samo jak błędna, więc modele trenowane pod te wyniki uczą się zgadywać pewnym tonem. Przykład z pracy jest wymowny: zapytany o datę urodzin jednego z autorów, model podał trzy różne daty w trzech próbach. Każda brzmiała równie przekonująco i żadna nie była prawdziwa.
Pewność w tonie odpowiedzi nie mówi nic o pewności wiedzy. Ton jest stały, bo tak model został wytrenowany. Wiedza za nim bywa pełna, szczątkowa albo żadna, a z samego tekstu tego nie odczytasz. Ludzie mają podobny kłopot, o czym więcej w tekście o efekcie Dunninga-Krugera, tyle że u modelu nie ma nawet zawahania w głosie.
Znajoma nazwa wyłącza modelowi hamulec
Drugi kawałek układanki pochodzi z zaglądania modelowi do środka. W marcu 2025 roku Anthropic opisał w pracy „On the Biology of a Large Language Model”, co dzieje się w modelu Claude 3.5 Haiku, kiedy dostaje pytanie o fakt. Badacze znaleźli mechanizm, który domyślnie jest włączony i każe odpowiedzieć „nie wiem”. Wyłącza go dopiero rozpoznanie: kiedy model trafia na nazwę, którą zna, hamulec puszcza i model zaczyna odpowiadać.
Kłopot pojawia się w środku skali. Nazwisko brzmi znajomo, ale konkretnej wiedzy o tej osobie brak. Hamulec i tak puszcza, a model wypełnia lukę czymś prawdopodobnym. Badacze potrafili zresztą wywołać halucynację celowo, sztucznie pobudzając obszar odpowiedzialny za „to znam”.
Wróć teraz do sceny z oferty. Znana firma badawcza to nazwa, którą model rozpoznaje bez trudu. Konkretna liczba z konkretnego raportu to już wiedza, której mógł nigdy nie widzieć. Najbardziej ryzykowne są więc pytania o rzeczy półznane: mało znany raport znanej firmy, rzadki przepis w znanej ustawie, szczegół z życia osoby, o której model słyszał, ale niewiele.
Nowszy model nie myli się rzadziej, za to mówi więcej
Intuicja podpowiada, że problem zniknie sam wraz z kolejnymi wersjami modeli. Dane z kwietnia 2025 roku tego nie potwierdzają. W karcie systemowej modeli o3 i o4-mini OpenAI pokazało wynik własnego testu PersonQA, w którym model odpowiada na pytania o osoby publiczne. Nowszy o3 halucynował w 33% odpowiedzi, starszy o1 w 16% (tabela z karty systemowej omówiona przez Simona Willisona).
Łatwo tę liczbę przeczytać źle. To wynik jednego wewnętrznego testu o faktach z życia ludzi, a nie odsetek błędów w każdej rozmowie. OpenAI zaproponowało też wyjaśnienie: o3 formułuje więcej twierdzeń w ogóle, więc rośnie zarówno liczba trafnych, jak i błędnych. Dłuższa i bardziej szczegółowa odpowiedź to więcej rzeczy do sprawdzenia, a nie dowód, że model wie więcej. Szczegół brzmi jak kompetencja i dlatego tak łatwo mu zaufać.
Model chętnie potwierdzi to, co już myślisz
Trzecie źródło wiarygodnych błędów siedzi w samym pytaniu. W 2023 roku zespół Anthropic opublikował badanie „Towards Understanding Sycophancy in Language Models” o skłonności modeli do przytakiwania rozmówcy. Pięć popularnych asystentów AI regularnie dopasowywało odpowiedzi do poglądów użytkownika. Autorzy wskazali też przyczynę: zarówno ludzie oceniający odpowiedzi, jak i modele oceniające uczone na ludzkich ocenach, w części przypadków woleli przekonująco napisaną odpowiedź przytakującą od poprawnej.
Przyjrzyj się prośbie ze sceny otwierającej: „znajdź statystykę, która pokaże, że usługa się opłaca”. To nie jest pytanie, tylko zamówienie na konkretny wynik. Model dostał tezę i zadanie jej podparcia, a trening nagradzał go za zadowolenie rozmówcy. Jeśli takiej liczby nie zna, ma silną pokusę, żeby ją dopasować.
Różnica w sformułowaniu jest niewielka, a skutek duży. „Jakie są dane o opłacalności tego typu usług, także te niekorzystne?” daje modelowi miejsce na odpowiedź, która Ci się nie spodoba. „Potwierdź, że…” takiego miejsca nie zostawia. Czy częściej pytasz pierwszym sposobem, czy drugim?
Wiarygodny błąd wychodzi na jaw u klienta, nie u Ciebie
Wspólną cechą głośnych wpadek z AI jest to, że błąd znalazł ktoś z zewnątrz. W przypadku Deloitte był to badacz z Uniwersytetu w Sydney, Chris Rudge, który w raporcie dla australijskiego ministerstwa zatrudnienia wskazał około dwudziestu błędów. Firma poprawiła dokument, dopisała informację o użyciu generatywnej AI i zwróciła ostatnią ratę za zlecenie.
W lutym 2024 roku kanadyjski trybunał rozstrzygnął sprawę Moffatt przeciwko Air Canada. Chatbot linii lotniczej poinformował klienta, że zniżkę na lot w związku ze śmiercią bliskiej osoby może wnioskować po podróży. Regulamin na stronie mówił co innego. Odpowiedź chatbota brzmiała dokładnie jak typowa polityka przewoźnika, więc klient nie miał powodu jej sprawdzać. Trybunał uznał, że firma odpowiada za informacje swojego chatbota, i zasądził 812,02 dolara kanadyjskiego razem z odsetkami i opłatami.
Air Canada nie wyjaśnia, dlaczego strona internetowa o podróżach w związku ze śmiercią bliskiej osoby miałaby być z natury bardziej wiarygodna niż jej chatbot.
— z uzasadnienia trybunału w sprawie Moffatt v. Air Canada, 2024 BCCRT 149
Najwięcej takich przypadków widać w sądach. Prawnik i badacz Damien Charlotin prowadzi bazę orzeczeń, w których sędziowie wytknęli pismom procesowym zmyślone przez AI cytaty i wyroki. W czerwcu 2026 roku zawierała około 1600 spraw z 35 krajów. Baza jest zbierana społecznościowo, więc to dolna granica, a nie pełny obraz. Prawnicy to ludzie zawodowo wyczuleni na błędne źródła. Mimo to zmyślony wyrok z prawdopodobną sygnaturą przechodził przez ich biurka, bo wyglądał jak setki prawdziwych.
Cztery miejsca, w których wiarygodne halucynacje chowają się najczęściej
Ze wszystkich opisanych wyżej przypadków da się wyciągnąć mapę. Wiarygodna halucynacja nie rozkłada się po tekście równo. Skupia się tam, gdzie forma jest przewidywalna, a treść trudna do sprawdzenia na oko.
Tytuł raportu, autor, rok, numer strony. Mają przewidywalny kształt, więc model składa je bez trudu. Tak powstały nieistniejące prace naukowe w raporcie Deloitte.
Procent, który podpiera dokładnie to, co chciałeś powiedzieć. Im lepiej pasuje, tym mniej chce Ci się go sprawdzać. To scena z oferty z początku tego tekstu.
„Zgodnie z regulaminem…”, „przepis mówi, że…”. Zasady firm i przepisy brzmią podobnie, więc wymyślona reguła wygląda jak prawdziwa. Tak pomylił się chatbot Air Canada.
Daty, stanowiska i szczegóły o osobach albo firmach, które model kojarzy, ale słabo. Rozpoznana nazwa wyłącza hamulec „nie wiem”, a wiedzy za nią brakuje.
Zauważ, że żadne z tych miejsc nie jest „trudnym tematem”. To zwykłe elementy, które pojawiają się w ofercie, poście na bloga czy mailu do klienta. Wystarczy, że w tekście od modelu jest choć jeden z nich, a tekst wychodzi poza firmę.
Pięć kroków, zanim wkleisz odpowiedź modelu do czegoś, co wychodzi z firmy
Wyłapywanie wiarygodnych błędów nie wymaga specjalistycznych narzędzi. Dwa z poniższych kroków to uproszczone wersje metod, które badacze sprawdzili w pracach naukowych, i oba da się zrobić w zwykłym oknie czatu.
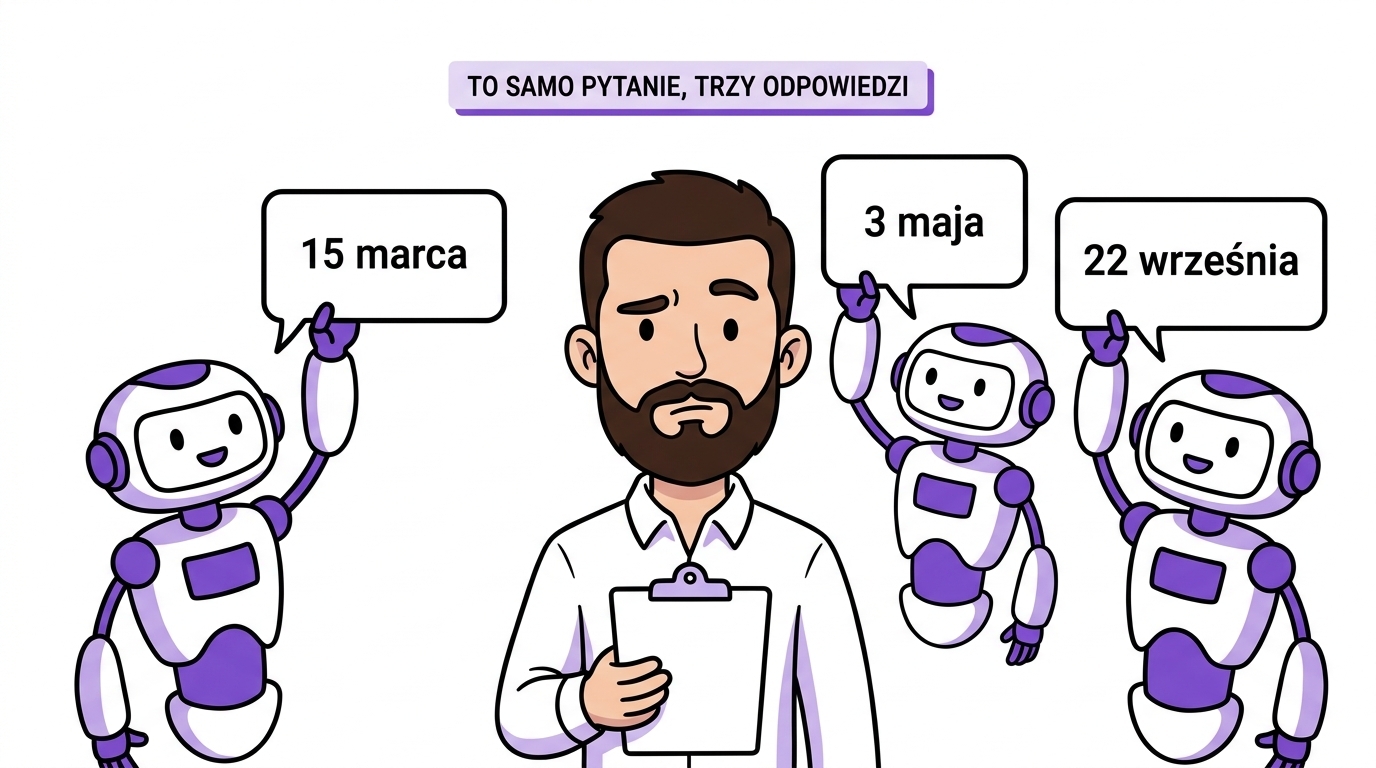
Krok trzeci opiera się na prostej obserwacji. Prawdę model powtarza, zgadywanie za każdym razem wypada inaczej, jak trzy daty urodzin z pracy OpenAI. Na tej różnicy zespół z Oksfordu zbudował w 2024 roku metodę semantycznej entropii, opisaną w „Nature”: model odpowiada wiele razy, a wysoki rozrzut znaczeń sygnalizuje konfabulację. Autorzy sami zaznaczają, że łapie to tylko jeden typ błędu. Model, który nauczył się nieprawdy, będzie ją powtarzał konsekwentnie, dlatego krok czwarty, czyli źródło pierwotne, zostaje obowiązkowy.
Krok piąty działa najlepiej, gdy model ma pod ręką Twoje materiały zamiast własnej pamięci. Ten sposób pracy nazywa się RAG i zmniejsza pole do zgadywania, choć go nie zeruje. Jak przygotować taką bazę, opisałem w tekście o tym, dlaczego prompt engineering to za mało.
Nie każdą odpowiedź trzeba sprawdzać tak samo
Gdyby każdą odpowiedź modelu weryfikować w pięciu krokach, praca z AI straciłaby sens. Rozsądniej zapytać, ile kosztuje błąd w tym konkretnym tekście. Granica jest prosta: sprawdzasz dokładnie wtedy, gdy tekst wychodzi poza firmę i ktoś podejmie na jego podstawie decyzję.
| Do czego używasz modelu | Koszt błędu | Co sprawdzić |
|---|---|---|
| Burza pomysłów, nazwy kampanii, szkic struktury | Niski | Nic poza własną oceną. Tu zgadywanie jest zaletą. |
| Szkic maila do klienta, którego znasz | Niski | Ton i każdą obietnicę terminu albo ceny. |
| Post lub wpis na bloga z danymi | Średni | Każdą liczbę i każde źródło w źródle pierwotnym. |
| Oferta, umowa, regulamin | Wysoki | Każde twierdzenie o przepisach, cenach i warunkach. |
| Chatbot odpowiadający klientom | Wysoki | Polityki firmy trzymane w bazie wiedzy, nie w pamięci modelu. |
Ostatni wiersz to lekcja z Air Canada. Jeśli model odpowiada klientom bez Twojego udziału, weryfikacji nie zrobisz po fakcie przy każdej rozmowie. Musisz ją wbudować w proces: dać modelowi dokumenty, z których ma odpowiadać, i ustalić, które odpowiedzi idą do człowieka. O tym, gdzie postawić taki punkt kontroli, piszę we wpisie o human in the loop.
Jedno pytanie, które zmienia sposób czytania odpowiedzi
Wszystkie mechanizmy opisane wyżej, czyli zgadywanie nagradzane w testach, puszczający hamulec przy znajomych nazwach i przytakiwanie rozmówcy, prowadzą do tego samego miejsca. Model najczęściej myli się tam, gdzie jego odpowiedź jest dla Ciebie najwygodniejsza.
Dlatego przy każdej odpowiedzi, która ma trafić do klienta, zadaj sobie jedno pytanie: czy sprawdziłbym to zdanie, gdyby mówiło coś odwrotnego? Jeśli tak, a teraz chcesz je wkleić bez sprawdzania, to właśnie znalazłeś miejsce, w którym zaczynasz od kroku pierwszego.
Jeśli tworzysz treści z AI regularnie i chcesz mieć cały proces, od briefu po weryfikację, poukładany w jednym miejscu, zajrzyj do kursu Tworzenie treści przy pomocy AI.
Sprawdźmy, co da się zdjąć z Twojej głowy
W którym miejscu Twojej firmy odpowiedź modelu trafia do klienta bez drugiej pary oczu? Napisz, jak dziś pracujesz z AI, a wskażę punkty, w których warto dołożyć weryfikację, i te, w których możesz ją spokojnie odpuścić.
Napisz do mnie →Najczęściej zadawane pytania
To nieprawdziwa informacja podana przez model językowy, która nie budzi podejrzeń, bo zgadza się z oczekiwaniami czytelnika. Może to być liczba podpierająca tezę, przypis do nieistniejącego raportu albo zmyślona reguła brzmiąca jak prawdziwy regulamin. W odróżnieniu od absurdalnych pomyłek takie błędy przechodzą przez kontrolę, bo nic w nich nie zgrzyta, i wychodzą na jaw dopiero u klienta albo odbiorcy tekstu.
Według pracy badaczy OpenAI z września 2025 roku modele są trenowane i oceniane na testach, które za odpowiedź „nie wiem” dają tyle samo punktów co za błędną. Zgadywanie statystycznie się opłaca, więc model uczy się odpowiadać pewnym tonem także wtedy, gdy nie ma wiedzy. Badania Anthropic pokazały dodatkowo, że rozpoznanie znajomej nazwy wyłącza w modelu mechanizm odmowy, nawet gdy konkretnych informacji brakuje.
Nie zawsze. W karcie systemowej z kwietnia 2025 roku OpenAI pokazało, że nowszy model o3 halucynował w 33% odpowiedzi wewnętrznego testu PersonQA, a starszy o1 w 16%. Wyjaśnieniem jest to, że o3 formułuje więcej twierdzeń, więc rośnie liczba zarówno trafnych, jak i błędnych. Dłuższa i bardziej szczegółowa odpowiedź oznacza więc więcej rzeczy do sprawdzenia, a nie większą pewność.
W czterech miejscach: w przypisach i nazwach raportów, w liczbach, które idealnie pasują do tezy, w regułach typu „zgodnie z regulaminem” lub „przepis mówi” oraz w szczegółach o osobach i firmach, które model kojarzy, ale słabo. Wszystkie mają przewidywalną formę i trudną do sprawdzenia na oko treść, dlatego warto weryfikować je w pierwszej kolejności, zanim tekst wyjdzie poza firmę.
Najpierw zaznacz zdania, które Ci pasują, bo te najłatwiej przepuścić. Rozbij odpowiedź na pojedyncze twierdzenia z liczbami, nazwami i datami. Zadaj to samo pytanie w nowej rozmowie: jeśli odpowiedź się zmienia, model zgaduje. Każdą liczbę znajdź w źródle pierwotnym, a nie tylko sprawdź, czy link działa. Na koniec dopisz do polecenia, że model może odpowiedzieć „nie wiem”.
Nie. Przy burzy pomysłów, nazwach kampanii czy szkicach struktury zgadywanie modelu bywa wręcz zaletą i wystarczy własna ocena. Dokładna weryfikacja ma sens wtedy, gdy tekst wychodzi poza firmę i ktoś podejmie na jego podstawie decyzję: w ofertach, umowach, regulaminach, wpisach z danymi oraz w odpowiedziach chatbota dla klientów, gdzie polityki firmy powinny pochodzić z bazy wiedzy.

Szymon Mojsak
Ekspert automatyzacji procesów biznesowych i współwłaściciel RCPonline — systemu rejestracji czasu pracy.
Teoria zastosowana w praktyce — treści opieram na własnych doświadczeniach zdobytych przy wdrożeniach i w relacjach międzyludzkich.
Poszerzam horyzonty — nieustannie rozwijam wiedzę z zakresu marketingu, psychologii i IT.
Zamieniam twórczy chaos w kierunek — najpierw pytanie „po co”, dopiero potem „jak”. Pomagam zrozumieć procesy, by je usprawnić.
Ten materiał powstał z udziałem AI
Narzędzia AI — wspierały research, redakcję tekstu i przygotowanie ilustracji.
Autor — wybiera temat, pisze pierwszą wersję i redaguje całość przed publikacją. Doświadczenia, oceny i punkt widzenia w tekście są jego własne.
Ładowanie komentarzy...