

Czyli o tym, dlaczego czterdziesta poprawka rzadko jest lepsza od pierwszej wiadomości w nowym oknie.
Czterdziesta wiadomość w tym samym wątku. Od rana dopracowujesz z modelem opis oferty dla nowego klienta. Na początku poprosiłeś o wersję luźną, potem o bardziej konkretną, potem kazałeś wyrzucić akapit o „kompleksowym wsparciu”, bo brzmiał jak z ulotki banku. Po drodze zmieniła się cena, doszedł drugi pakiet i zdanie o terminach.
Prosisz o ostatnią poprawkę: skrócić wstęp. Model skraca. I wstawia z powrotem „kompleksowe wsparcie”. Trzeci raz od rana.
Piszesz „przecież to usunęliśmy”. Model przeprasza, poprawia, a przy okazji gubi drugi pakiet.
Prawie każdy reaguje tak samo: dopisuje kolejną poprawkę, tym razem wielkimi literami. W końcu model ma przed sobą całą rozmowę, wszystkie ustalenia są na ekranie, więc wystarczy mu je przypomnieć. A gdyby właśnie ta cała rozmowa była problemem?
To zjawisko ma dwie nazwy, zależnie od tego, kto je mierzy. Badacze piszą o tym, że modele gubią się w rozmowie wieloturowej (lost in multi-turn conversation), a producenci modeli używają określenia context rot, czyli psucie się kontekstu: im więcej tekstu model ma przed sobą, tym gorzej z niego korzysta. Długi wątek wydaje się rozsądnym wyborem, bo w nim są wszystkie ustalenia i nie trzeba niczego powtarzać. Kłopot w tym, że są tam też wszystkie odrzucone wersje.
Model nie pamięta rozmowy, tylko czyta ją od nowa przy każdej odpowiedzi
Model językowy nie ma pamięci w ludzkim sensie. Przy każdej Twojej wiadomości dostaje całą dotychczasową rozmowę jako jeden długi tekst i na jego podstawie pisze kolejną odpowiedź. Dokumentacja Anthropic opisuje to wprost: każda wiadomość użytkownika i każda odpowiedź asystenta odkłada się w oknie kontekstowym, a wcześniejsze tury zostają w nim w całości.
Ze słownika Noraline: okno kontekstowe to cały tekst, który model bierze pod uwagę, pisząc odpowiedź: instrukcje, rozmowa, wklejone pliki i sama odpowiedź. Producenci nazywają je pamięcią roboczą modelu. Mierzy się je w tokenach, czyli kawałkach słów.
Z tego wynika rzecz, którą łatwo przeoczyć. Kiedy piszesz „wyrzuć ten akapit”, akapit nie znika. Zostaje w rozmowie razem z Twoją prośbą o jego usunięcie. Przy czterdziestej wiadomości model czyta więc jednocześnie trzy wersje wstępu, dwie ceny, jeden pakiet sprzed zmiany i jeden po zmianie. Z tego wszystkiego ma sam ustalić, co obowiązuje.
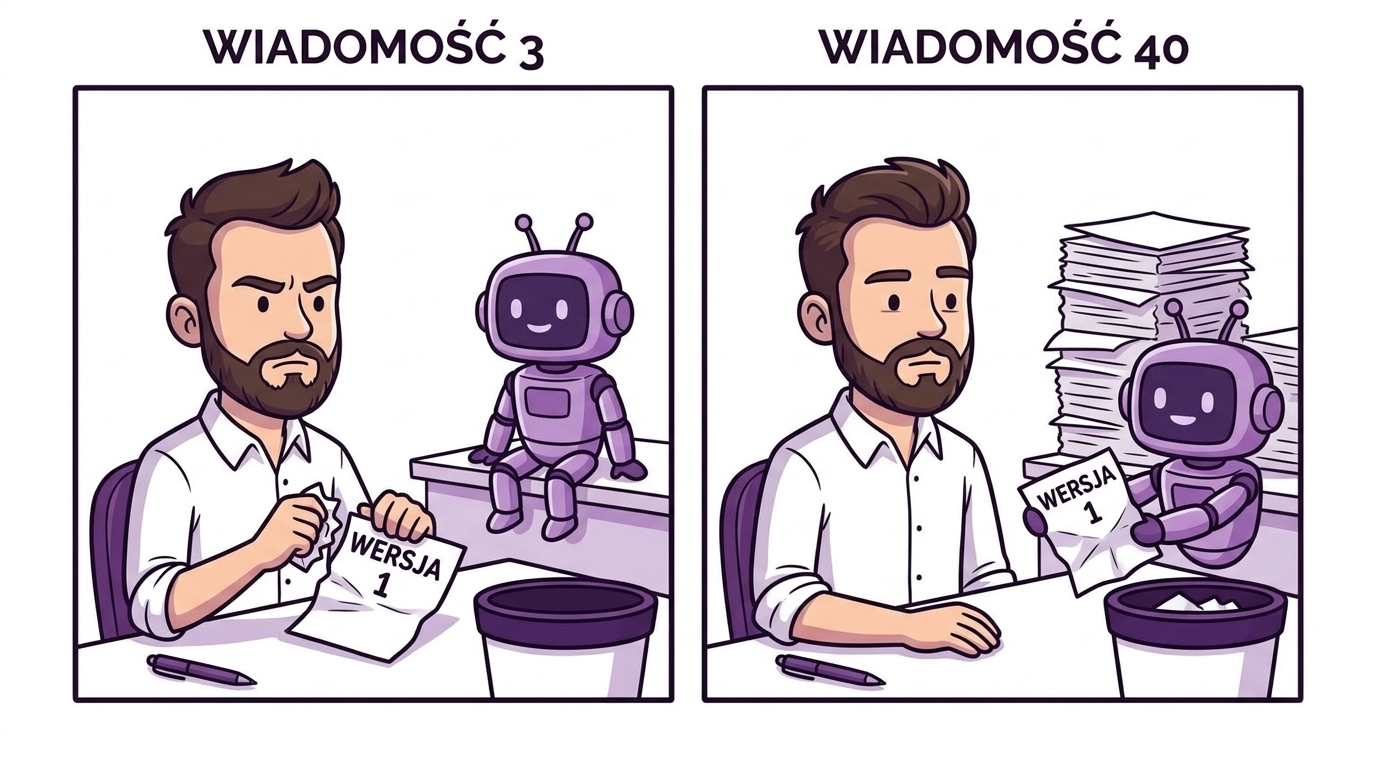
Człowiek robi to bez wysiłku, bo pamięta, która decyzja była ostatnia i dlaczego. Model ma przed sobą tylko tekst, w którym odrzucona wersja jest napisana równie starannie jak obowiązująca. Często nawet staranniej, bo pierwszą odpowiedź napisał sam, w pełnej formie, a Twoje późniejsze poprawki to krótkie, rzucane w pośpiechu zdania.
W rozmowie na raty modele tracą średnio 39 procent jakości
W maju 2025 roku badacze z Microsoft Research i Salesforce Research opublikowali pracę „LLMs Get Lost In Multi-Turn Conversation”. Sprawdzili 15 modeli z ośmiu rodzin, w tym najmocniejsze modele komercyjne i otwarte, na sześciu typach zadań: między innymi pisanie kodu, zapytania do bazy danych i streszczanie dokumentów. Przeprowadzili ponad 200 tysięcy symulowanych rozmów.
Pomysł był prosty. To samo zadanie podawali modelowi na dwa sposoby. Raz w jednej, kompletnej wiadomości. Drugi raz w kawałkach, rozłożonych na kilka wiadomości, tak jak zwykle rozmawia człowiek, który dopowiada szczegóły w miarę, jak mu się przypominają. Treść wymagań była w obu przypadkach identyczna.
Wynik: w rozmowie na raty jakość odpowiedzi spadała średnio o 39%. W jednej wiadomości modele osiągały średnio około 90% możliwego wyniku, w rozmowie rozłożonej na tury około 65%. Spadek dotyczył wszystkich badanych modeli, także tych z czołówki rankingów.
Badacze przy tym nie testowali rozmów na czterdzieści wiadomości. Wystarczyło, że te same informacje przychodziły po kawałku. Prawdziwy wątek, w którym coś odrzucasz, zmieniasz zdanie i wracasz do wcześniejszego pomysłu, jest dla modelu trudniejszy niż ich eksperyment, a nie łatwiejszy.
Gorzej nie znaczy głupiej: rośnie rozrzut, nie spada umiejętność
Najciekawsza część badania dotyczy tego, jak modele się psują. Autorzy rozdzielili spadek jakości na dwie składowe. Pierwsza to umiejętność, czyli najlepszy wynik, jaki model potrafi osiągnąć w danym zadaniu. Druga to zawodność, czyli różnica między najlepszą a najgorszą próbą przy tym samym zadaniu.
Umiejętność w rozmowie na raty spadała o około 16%, czyli niewiele. Zawodność rosła o około 112%, czyli ponad dwukrotnie. Model w długiej rozmowie potrafi dalej napisać świetną odpowiedź. Tyle że równie dobrze może napisać bardzo słabą, i nie wiesz z góry, którą dostaniesz.
Najlepszy wynik modelu w rozmowie na raty spada o około 16%. Model nadal potrafi napisać dobrą odpowiedź.
Różnica między najlepszą a najgorszą próbą rośnie o około 112%. Nie wiesz, którą z nich dostaniesz.
Kiedy model w czterdziestej wiadomości zgubił drugi pakiet, odruchowo uznajesz, że „dziś słabo myśli” albo że trzeba lepiej sformułować prośbę. Tymczasem on się nie zepsuł. Pracuje w warunkach, w których jego wyniki rozjeżdżają się na wszystkie strony, a Ty losujesz kolejne odpowiedzi z coraz szerszego worka.
Czy kolejna poprawka wielkimi literami zawęzi ten worek? Raczej dorzuci do niego jeszcze jedną wiadomość.
Pierwsza odpowiedź zostaje kotwicą dla wszystkich kolejnych
Badacze z Microsoftu i Salesforce wskazali też, skąd bierze się ten rozrzut. Modele we wczesnych turach rozmowy robią założenia i przedwcześnie próbują podać gotowe rozwiązanie, a potem nadmiernie się na nim opierają. Kiedy w kolejnych wiadomościach dochodzą nowe informacje, model nie zaczyna od nowa. Łata swoją pierwszą odpowiedź.
„Wystarczy przypomnieć modelowi, co ustaliliśmy.” Przypomnienie to kolejna krótka wiadomość, a pierwsza wersja tekstu dalej leży w rozmowie w pełnej, dopracowanej formie.
Autorzy opisują przy tym zjawisko, które nazywają puchnięciem odpowiedzi. Model, który oparł się na błędnej wcześniejszej próbie, pisze kolejne odpowiedzi coraz dłuższe, bo próbuje pogodzić stare założenia z nowymi wymaganiami. Zamiast wyrzucić to, co nie pasuje, dokłada zdania, które mają wszystko uzgodnić.
Wróć do sceny z ofertą. „Kompleksowe wsparcie” pojawiło się w pierwszej, pełnej wersji tekstu, którą model napisał sam. Twoje „wyrzuć ten akapit” to jedno krótkie zdanie, a oryginalny akapit to kilkadziesiąt słów napisanych płynnie, w tonie całej oferty. Model, który przy skracaniu wstępu przegląda rozmowę w poszukiwaniu materiału, znajduje tam gotowy, dobrze brzmiący fragment. Wstawia go z powrotem.
To zachowanie ma pokrewne zjawisko, opisane we wpisie o tym, dlaczego model AI przyznaje Ci rację. Tam model dopasowuje ocenę do tego, co chcesz usłyszeć. Tutaj dopasowuje odpowiedź do tego, co sam wcześniej napisał. W obu przypadkach to, co już jest w rozmowie, waży więcej niż to, co jest prawdą o zadaniu.
Odrzucone wersje działają jak fałszywe tropy
Drugi mechanizm dotyczy samej długości tekstu. W lipcu 2025 roku firma Chroma, która buduje bazy danych dla aplikacji AI, opublikowała raport „Context Rot”. Zespół sprawdził 18 modeli, wśród nich GPT-4.1, Claude 4, Gemini 2.5 i Qwen3. Wniosek autorów: modele nie korzystają z kontekstu równomiernie, a ich wyniki stają się coraz bardziej zawodne w miarę, jak tekst wejściowy się wydłuża. Działo się to nawet przy bardzo prostych zadaniach.
Szczególnie ważny dla długich czatów jest eksperyment z tzw. dystraktorami, czyli fragmentami tekstu podobnymi do właściwej odpowiedzi, ale jej niezawierającymi. Już jeden taki fragment obniżał wyniki w porównaniu z tekstem, w którym była tylko właściwa informacja. Cztery obniżały je jeszcze bardziej.
Odrzucona wersja wstępu to podręcznikowy dystraktor. Jest na ten sam temat, w tym samym stylu, dotyczy tej samej oferty. Różni się tylko tym, że już nie obowiązuje, a tego model nie widzi w samym tekście akapitu.
Raport Chroma sprawdził też coś, co bezpośrednio przypomina pracę w czacie. Modele odpowiadały na pytania o długą historię rozmowy w dwóch wariantach: z pełną historią liczącą średnio około 113 tysięcy tokenów albo tylko z potrzebnymi fragmentami, średnio około 300 tokenów. Wszystkie modele wypadały wyraźnie lepiej w wersji skróconej, choć informacja potrzebna do odpowiedzi była w obu.
Starsze badanie zespołu ze Stanfordu, „Lost in the Middle” z 2023 roku, dokłada do tego obraz położenia. Modele najlepiej wykorzystywały informacje stojące na początku albo na końcu długiego tekstu, a wyraźnie gorzej te ze środka. W długim wątku środek to zwykle właśnie te ustalenia, które były ważne, ale padły dawno.
Okno na milion tokenów nie chroni przed długim wątkiem
Producenci chętnie chwalą się rozmiarem okna kontekstowego. Część najnowszych modeli Claude ma okno na milion tokenów, co odpowiada kilku grubym książkom. Łatwo z tego wyciągnąć wniosek, że czterdzieści wiadomości to dla takiego modelu drobiazg.
Ta sama dokumentacja w następnym zdaniu studzi entuzjazm. Anthropic pisze, że większe okno pozwala obsłużyć dłuższe i bardziej złożone polecenia, ale więcej kontekstu nie jest automatycznie lepsze: wraz ze wzrostem liczby tokenów spadają dokładność i przywoływanie informacji. W tekście o projektowaniu kontekstu dla agentów firma tłumaczy też, skąd to się bierze. Model ma ograniczony „budżet uwagi”, a każdy nowy token zużywa jego część.
Pojemność okna mówi więc, ile tekstu model przyjmie, zanim odmówi. Nie mówi, jak dobrze z tego tekstu skorzysta. Dochodzi do tego jeszcze jedna rzecz: według tej samej dokumentacji interfejsy czatu, takie jak claude.ai, mogą przy bardzo długich rozmowach zarządzać oknem na zasadzie „pierwsze weszło, pierwsze wychodzi”. OpenAI ma w centrum pomocy osobny artykuł o komunikacie „Context window full”. W bardzo długim wątku najstarsze ustalenia mogą więc wypaść z pola widzenia modelu zupełnie, a z samej odpowiedzi trudno to poznać.
Wpis o bazie wiedzy dla AI pokazywał, że model pracuje tak dobrze, jak dobry materiał mu podasz. Długi wątek to ten sam problem od drugiej strony: materiał jest, tylko zmieszany z odpadami.
Kiedy zacząć nowy czat: cztery sygnały
Nie każda długa rozmowa się psuje. Jeśli przez godzinę zadajesz modelowi niezależne pytania o różne funkcje arkusza kalkulacyjnego, długość wątku niewiele szkodzi, bo żadna odpowiedź nie musi pamiętać poprzedniej. Kłopot zaczyna się tam, gdzie razem z modelem budujesz jeden tekst, plan albo fragment kodu i po drodze zmieniasz ustalenia. Wtedy warto patrzeć na cztery sygnały.
Żaden z tych sygnałów nie wymaga liczenia wiadomości. Czterdziesta wiadomość ze sceny otwarcia nie jest progiem, po którym wątek się psuje. Bywają rozmowy, które po dwudziestu wymianach są już nie do uratowania, i takie, które przy sześćdziesięciu działają dobrze, bo nikt w nich niczego nie odwoływał.
Najbardziej wiarygodny jest pierwszy sygnał. Model, który wraca do odrzuconej wersji, pokazuje Ci wprost, że w tej rozmowie stare ustalenia przeważają nad nowymi. Kolejna poprawka dopisze tylko jeszcze jedno krótkie zdanie po stronie nowych.
Streszczenie przed przeprowadzką odzyskuje większość straty
Badacze z Microsoftu i Salesforce nie poprzestali na zmierzeniu problemu. Przetestowali też dwa sposoby jego łagodzenia. W pierwszym, nazwanym recap, na końcu rozmowy model dostawał jeszcze raz wszystkie wymagania zebrane w jednej wiadomości. W drugim, nazwanym snowball, każda kolejna wiadomość powtarzała wszystkie wcześniejsze wymagania i dokładała nowe.
| Sposób podania zadania | GPT-4o-mini | GPT-4o |
|---|---|---|
| Całe zadanie w jednej wiadomości | 86,8 | 93,0 |
| Zadanie rozłożone na kilka wiadomości | 50,4 | 59,1 |
| Rozłożone, ale z podsumowaniem na końcu (recap) | 66,5 | 76,6 |
| Rozłożone, każda wiadomość powtarza poprzednie (snowball) | 61,8 | 65,3 |
Wyniki w tabeli pochodzą z pełnej wersji pracy Labana i współautorów i są średnią z czterech zadań. Oba sposoby pomagały, żaden nie dorównywał podaniu całego zadania od razu. Najwięcej odzyskiwało zebranie wszystkiego w jedno miejsce.
Autorzy kończą pracę dwiema radami dla zwykłych użytkowników i obie da się zastosować od razu. Pierwsza: jeśli masz czas, spróbuj jeszcze raz, bo nowa rozmowa z tymi samymi informacjami może dać lepszy wynik niż kontynuowanie takiej, która zboczyła z kursu. Druga: zanim spróbujesz ponownie, poproś model o zebranie wszystkiego, co padło w rozmowie, i użyj tego streszczenia w nowym czacie.
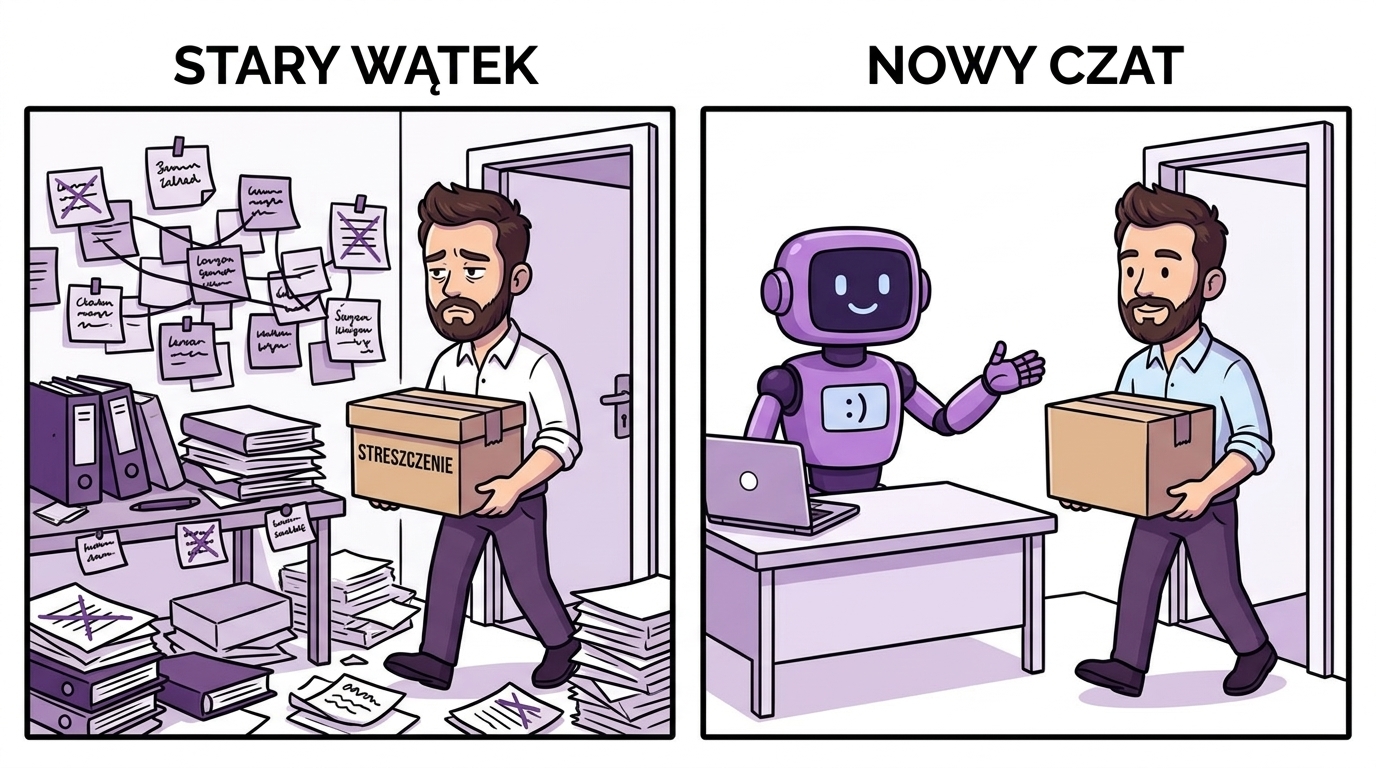
Tak samo robią zresztą sami producenci w swoich narzędziach. Anthropic opisuje technikę, którą nazywa kompaktowaniem: kiedy rozmowa zbliża się do limitu, jej treść jest streszczana, a praca startuje w nowym oknie kontekstowym z tym streszczeniem. Ty możesz zrobić to samo ręcznie i wcześniej, zanim wątek zacznie Ci przeszkadzać.
Prompt do streszczenia, które da się wkleić w nowe okno
Dobre streszczenie różni się od zwykłego „podsumuj rozmowę” jedną rzeczą: zawiera tylko to, co obowiązuje teraz, i wprost wymienia to, co odrzuciłeś. Odrzucone rzeczy trafiają do niego jako zakazy, a nie jako materiał do wykorzystania. Na końcu starego wątku wklej mniej więcej coś takiego:
Zanim skończymy, zbierz wszystko, co ustaliliśmy w tej rozmowie,
w formie instrukcji dla kogoś, kto zaczyna tę pracę od zera.

1. Cel: co powstaje i dla kogo.
2. Ustalenia, które obowiązują TERAZ (ostatnia wersja każdej decyzji,
   bez historii zmian).
3. Czego NIE robić: fragmenty, sformułowania i pomysły, które odrzuciłem.
4. Ostatnia zaakceptowana wersja tekstu w całości.
5. Co zostało do zrobienia.

Nie dodawaj niczego, czego nie ustaliliśmy. Jeśli coś jest niejasne,
napisz to w osobnym punkcie „Do potwierdzenia”.
Przeczytaj streszczenie, zanim je przeniesiesz. Model pisze je z tego samego długiego wątku, więc może pomylić, która cena była ostatnia. Poprawienie streszczenia zajmuje dwie minuty, bo masz przed sobą jedną stronę zamiast czterdziestu wiadomości. Punkt „Do potwierdzenia” pokaże Ci zwykle dokładnie te miejsca, w których model się gubił.
Potem otwierasz nowy czat, wklejasz streszczenie i dopiero pod nim piszesz prośbę, na której utknąłeś: skrócić wstęp. Jeśli pracujesz z tym samym materiałem regularnie, zapisz streszczenie w pliku albo w instrukcjach projektu w ChatGPT czy Claude. Następnym razem nie będziesz musiał go odtwarzać z rozmowy.
Sprawdź to na jednym zadaniu, zanim uwierzysz
Wszystkie liczby z tego wpisu pochodzą z eksperymentów na zadaniach testowych, a Twoja oferta nie jest zadaniem testowym. Dlatego rada sprowadza się do próby, a nie do reguły.
Jeśli nowa jest lepsza, masz odpowiedź na pytanie z tytułu dla swojej pracy, a nie dla cudzego badania. Jeśli nie jest, problem prawdopodobnie leży gdzie indziej, na przykład w tym, że model nie ma potrzebnych informacji. Wtedy warto zajrzeć do tekstu o wiarygodnych halucynacjach, bo model, któremu brakuje danych, chętnie je dopowiada.
„Kompleksowe wsparcie” z oferty prawie na pewno nie przeżyje przeprowadzki. W streszczeniu będzie stało w punkcie trzecim, jako coś, czego nie robić.
Sprawdźmy, co da się zdjąć z Twojej głowy
Ile razy w tygodniu tłumaczysz modelowi od nowa, kim jest klient, jaki masz cennik i jak piszesz? Pomogę ułożyć stałe instrukcje i bazę wiedzy tak, żeby każda rozmowa startowała z tym samym, aktualnym materiałem.
Napisz do mnie →Najczęściej zadawane pytania
Model przy każdej odpowiedzi czyta całą dotychczasową rozmowę, razem z odrzuconymi wersjami. Twoje polecenie usunięcia fragmentu to krótkie zdanie, a sam fragment stoi w rozmowie w pełnej, dopracowanej formie. Badania pokazują, że modele mocno opierają się na swoich wczesnych odpowiedziach, a podobne, ale nieaktualne fragmenty tekstu obniżają trafność odpowiedzi. Dlatego odrzucona wersja potrafi wrócić kilka razy.
W badaniu Microsoft Research i Salesforce Research z 2025 roku 15 modeli rozwiązywało te same zadania podane w jednej wiadomości albo rozłożone na kilka. W rozmowie na raty jakość spadała średnio o 39 procent. Najlepszy możliwy wynik spadał tylko o około 16 procent, za to rozrzut między dobrą i słabą odpowiedzią rósł ponad dwukrotnie. Model wciąż potrafi odpowiedzieć dobrze, tylko robi to mniej przewidywalnie.
Nie. Rozmiar okna kontekstowego mówi, ile tekstu model przyjmie, a nie jak dobrze z niego skorzysta. Anthropic w dokumentacji pisze wprost, że więcej kontekstu nie jest automatycznie lepsze, bo wraz ze wzrostem liczby tokenów spadają dokładność i przywoływanie informacji. Raport firmy Chroma z 2025 roku pokazał, że 18 modeli radziło sobie wyraźnie lepiej z krótkim, wybranym fragmentem rozmowy niż z pełną historią.
Najlepiej wtedy, gdy model drugi lub trzeci raz wraca do fragmentu, który kazałeś usunąć, gdy poprawka jednej rzeczy psuje inną, ustaloną wcześniej, gdy kolejne odpowiedzi robią się coraz dłuższe mimo próśb o skrócenie albo gdy zmieniłeś temat rozmowy. Liczba wiadomości sama w sobie nie jest progiem. Liczy się to, czy w wątku zebrało się dużo odwołanych ustaleń.
Poproś model w starym wątku o streszczenie w formie instrukcji dla kogoś, kto zaczyna pracę od zera: cel, ustalenia obowiązujące teraz, lista rzeczy odrzuconych, ostatnia zaakceptowana wersja i to, co zostało do zrobienia. Przeczytaj i popraw streszczenie, bo model może pomylić kolejność decyzji. Potem wklej je na początku nowego czatu i dopiero pod nim zadaj właściwą prośbę.
W badaniu Labana i współautorów zebranie wszystkich wymagań w jednej wiadomości na końcu rozmowy podniosło wynik GPT-4o z 59,1 do 76,6 punktu, a GPT-4o-mini z 50,4 do 66,5. Nie dorównało to podaniu całego zadania od razu, ale odzyskało większość straty. Autorzy wprost radzą użytkownikom, żeby przed ponowną próbą poprosić model o zebranie ustaleń i użyć ich w nowej rozmowie.

Szymon Mojsak
Ekspert automatyzacji procesów biznesowych i współwłaściciel RCPonline — systemu rejestracji czasu pracy.
Teoria zastosowana w praktyce — treści opieram na własnych doświadczeniach zdobytych przy wdrożeniach i w relacjach międzyludzkich.
Poszerzam horyzonty — nieustannie rozwijam wiedzę z zakresu marketingu, psychologii i IT.
Zamieniam twórczy chaos w kierunek — najpierw pytanie „po co”, dopiero potem „jak”. Pomagam zrozumieć procesy, by je usprawnić.
Ten materiał powstał z udziałem AI
Narzędzia AI — wspierały research, redakcję tekstu i przygotowanie ilustracji.
Autor — wybiera temat, pisze pierwszą wersję i redaguje całość przed publikacją. Doświadczenia, oceny i punkt widzenia w tekście są jego własne.
Ładowanie komentarzy...